- 設問1
- 設問2
- (1)a: b: c: d: e:ルーティングテーブル(RIB) f:
- (2)自身のIPアドレス
- (4)VRRPマスターになったR13が経路情報を保持していないと受信したパケットを転送できないから
- (5)確認事項:パケットロスが発生しないこと① [送信元:R13 宛先:FW10] or [送信元:FW10 宛先:R13] or [送信元:R13 宛先:R11] or [送信元:R11 宛先:R13] ② [送信元:R14 宛先:R13] or [送信元:R13 宛先:R14]
- (7)① R11② R13③ R11 と R12 とを接続する回線④ R13 と R14 とを接続する回線⑤ R11 と L2SW10 とを接続する回線⑥ R13 と L2SW10 とを接続する回線
- 設問3
- (1)ルーティングのループが発生する
- (3)送信元IPアドレスがプロキシサーバAで宛先IPアドレスがインターネットであった場合にネクストホップをR10とする設定
- p.2 Q.IaaS(Infrastracture as a Service)って何?
- p.2 Q.閉域網ってなに?
- Q.閉域網とインターネットVPN(IPsecなど)の違いは?
- Q.IaaSと閉域網の連携は誰が負担するの?
- Q.もし、IaaSがサポートしていない閉域網を自社で使っていたら?
- p.3 A社の静的経路制御とは?
- p.3 “開発サーバをシステム部が構築”って具体的に何をやっているの?
- p.3 サーバがプロキシを使うとは?
- Q.NAPTとは?
- Q.キャッシュDNSサーバのフローはどうなってる?
- Q.DNSSECとは?
- p.5 プロキシサーバを動的に切り替える方法は?
- p.7 Q.マルチホーム環境でも静的経路で対応できるのでは?
- Q.VRRPとは?
- p.8 Q.専用線で接続するとは物理的にどうやっているの?
- p.8 Q.なぜBGPをすぐに確立しないの?また、それは技術的に可能なの?
設問1
(1)DNSラウンドロビン
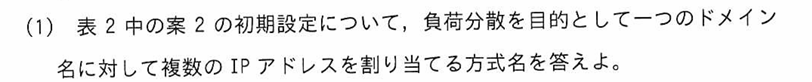
1つのドメイン名に対して複数のIPアドレスを割り当てることをDNSラウンドロビンという。
▼具体的な挙動
例えば、同一ドメインに対して3つのAレコード(IPアドレス(IP-1, IP-2, IP-3))が登録されている場合、DNSサーバは以下のように応答する。
1回目の問い合わせ:[ IP-1, IP-2, IP-3 ] の順番で返す
2回目の問い合わせ:[ IP-2, IP-3, IP-1 ] の順番で返す
3回目の問い合わせ:[ IP-3, IP-1, IP-2 ] の順番で返す
1件だけ返してしまうと、そのサーバが死んでいた場合にPCは通信不能になる。複数件まとめて返しておけば、PCは「先頭のIP(例: IP-1)に接続を試みてタイムアウトしたら、2番目のIP(例: IP-2)へ自動的に再接続する」という動作ができるため、クライアント側での簡易的な障害回避が可能になる。
(3)192.168.2.145
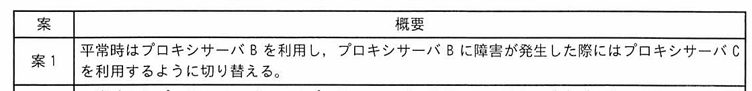
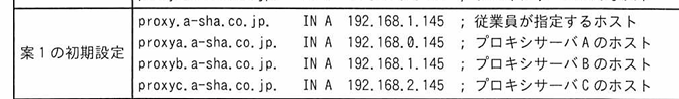
切り替え後、つまり障害が発生した際にはどのプロキシサーバを使うかが聞かれている。
案1を見ると、通常時はB(192.168.1.145)が使われて、障害時はCに切り替えると書かれているのでCのIPアドレスである192.168.2.145を指定することが推測される。
*注意!案2でもDNSのIPアドレス変更は必須

正直、案2の場合はDNSを書き換えなくても、クライアントには複数レコードが配られるので自動でフェイルオーバーできるから書き換える必要はないのでは??という発想が生まれる。
しかし、クライアント側に自動フェイルオーバーがない場合はアクセスできなくなってしまう。また、もしもフェイルオーバー機能があったとしても、障害発生プロキシのIPが先頭の状態で届いたクライアントは確実に1回はアクセスできないサーバにアクセスしなければならず、それは非効率。
そのため、ワンちゃんフェイルオーバー機能で通信できるかもしれないけど、ユーザに迷惑をかける確率の方が高いので障害が起きたらしっかりとDNS設定を変更しようよね!ということ。
(5)方法:プロキシ自動設定機能を利用する 制限事項:対応するPCやサーバでしか利用できない
では、一つずつ分解しながら回答を導いていこう!
Q.DNSとは異なる方法とは?
「DNSとは異なる方法」とは、DNSゾーンファイルの書き換えを行わずに、端末自身に即座に正常なプロキシへ切り替えさせることを意味している。指している。
Q.プロキシサーバを利用する側の環境とは?
「プロキシサーバを利用する側の環境」とは、つまりプロキシサーバを使うユーザ/クライアント側の環境を意味する
Q.そもそもユーザはどうやってホスト名を知っているの?
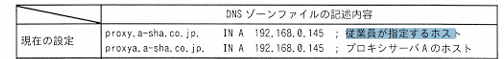
「従業員が指定するホスト」と書かれているが、もしもこれがユーザの持つPACファイルに書かれた情報をもとにしているのであれば、WPADなんか使わずに、最初からこのPACファイルに負荷分散をするJavaScriptを書けばいいのでは?
#負荷分散ができるJavaScript
function FindProxyForURL(url, host) {
    // クライアントのランダム値で50%の確率で優先順位を反転
    if (Math.random() < 0.5) {
        return "PROXY ProxyB:8080; PROXY ProxyC:8080";
    } else {
        return "PROXY ProxyC:8080; PROXY ProxyB:8080";
    }
}A.結論として、元々はPACファイルではなく、ブラウザにホスト名が直接設定されている状態である。PCのキッティング時やActive Directoryのグループポリシー(GPO)によって、ブラウザの「プロキシ設定」の項目に、手動設定の形で proxy.a-sha.co.jp:8080 と直書きされている。したがって、クライアントは通信のたびに proxy.a-sha.co.jp のIPアドレスをDNSに問い合わせをしている。
結論
以上の点から、PACファイルを動的に配ることができれば、ブラウザに直書きの情報ではなくPACによる制御に変えられる。PACには以下のようなプロキシを負荷分散できるJavaScriptを書くことができるので、PACファイルさえ配れれば案2を満たすことができる。
そして先ほどから挙がるプロキシを動的に配る方法こそがプロキシ自動設定機能(WPAD:WebProxyAuto-Discovery)である。これはプロキシをDNSやDHCPなどの機能を使って配布する方法である。しかし、そもそもの前提として、これをWPADを利用するには、プロキシを利用するクライアント端末(OS、ブラウザ、アプリ)側が、PACファイル(JavaScript)を実行・解釈する機能を持っている必要がある。つまりは対応するPCやサーバでしか利用できないということ。
#負荷分散ができるJavaScript
function FindProxyForURL(url, host) {
    // クライアントのランダム値で50%の確率で優先順位を反転
    if (Math.random() < 0.5) {
        return "PROXY ProxyB:8080; PROXY ProxyC:8080";
    } else {
        return "PROXY ProxyC:8080; PROXY ProxyB:8080";
    }
}
▼WPADの詳しいフローなどはこちら

設問2
(1)a: b: c: d: e:ルーティングテーブル(RIB) f:
e:ルーティングテーブル(RIB)
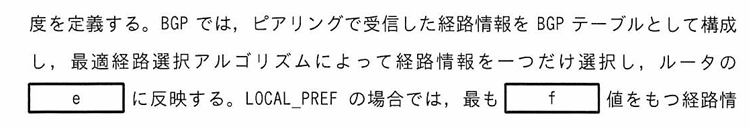
これを間違えてFIBと回答してしまう人が多々いる。なので、ここではRIB、FIB、ルーティングテーブルの違いをササっと見ていこう!
▼簡易的な流れ
1.ルーティングプロトコルが自身のアルゴリズムをベースに最適パスを見つける。その最適パスをRIBに提出する
2.RIBはAD値で比較してどのプロトコル(OSPF,BGP,EIGRPなど)を最適経路として扱うかを決める。これがいわゆるルーティングテーブルに登録するという段階
3.パケット転送には、ネクストホップのIPアドレスだけでなく、ネクストホップのMAC、そこに行くための送信ポートを検索する必要がある。それらを毎回やるのは非効率なので1つのテーブルとしてまとめておいてくれるのがFIB。
| テーブル名 | 別名・担当領域 | 役割と登録される情報 |
| BGP/OSPFテーブル | 各プロトコルのデータベース | 各プロトコル内で選出された「プロトコル内ベストパス(候補)」を保持する。 |
| ルーティングテーブル | RIB(CPU / ソフトウェア) | 複数プロトコルからのベストパスをAD値で比較し、勝ち残った「真の最適経路」を登録する。一般的に「ルーティングテーブル」といえばこのRIBを指す。 |
| FIB | 転送テーブル(ASIC / ハードウェア) | RIBの情報をもとに、**「宛先IP ➔ 出力ポート + 送信先MAC」**の3要素をあらかじめ計算・バインドした「事前計算済みのカンニングペーパー」。 |
▼FIBとは?
たとえば、BGPで学習したRIBの情報は次のようになっている。
宛先:
10.0.0.0/8➔ ネクストホップ:192.168.1.1
これを受け取ったルータは、パケットを目の前のLANケーブルに流すために、以下の3ステップの検索を毎回行わなければならない。
- RIBを検索(1回目):宛先
10.0.0.0/8に行くには192.168.1.1に送ればいいな。 - RIBを再検索(2回目):で、
192.168.1.1に送るにはどの物理ポート(例:Ge0/0/1)から出せばいいんだ?(直結経路の確認) - ARPテーブルを検索(3回目):
192.168.1.1のMACアドレスは何だ?
パケットが1個届くたびに、CPUがルーティングテーブルとARPテーブルを何回も往復して検索(再帰検索)していたら、毎秒数百万〜数億個届くパケットを捌ききれない。そこで、BGP更新や静的経路の変更があった時に、あらかじめCPUがこの3ステップを事前に計算して解決した「カンニングペーパー」を作成する。これがFIB。
(2)自身のIPアドレス
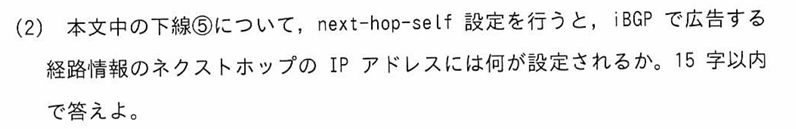
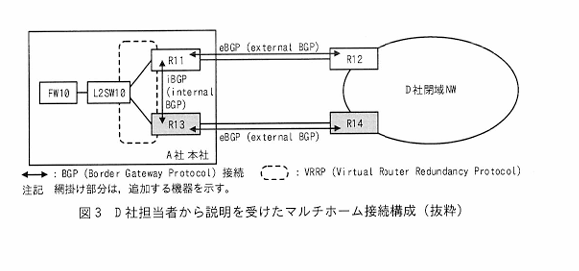
R13はR11からR12の情報をもらった場合、ネクストホップはR12となっている。なぜならiBGPではネクストホップを変えずに流すから。そのため、R13はR12と接続していないので、その経路は無効扱いになってしまう。R13はR11からR12の情報をもらった場合、ネクストホップはR12となっている。なぜならiBGPではネクストホップを変えずに流すから。そのため、R13はR12と接続していないので、その経路は無効扱いになってしまう。それを防ぐために、R11ではnext-hop-selfをつかう。next-hop-selfを使うことで、ネクストホップを自身のIPアドレスに上書きできる。これによりR13はR11からもらうR12からの経路も有効として判断できる。
これは、R13からR11に渡す場合も同様である。
(4)VRRPマスターになったR13が経路情報を保持していないと受信したパケットを転送できないから
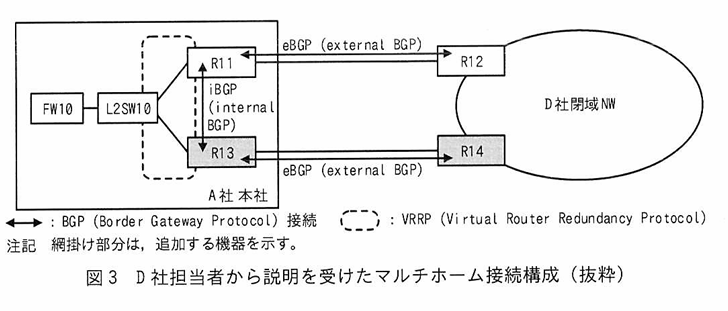
Q.BGPを行った後にVRRPを導入する理由は?
A.もし、先にVRRPを稼働させた場合、誤ってR13がマスタになるとR13は経路情報をまだ学習できていないので、流れてきたパケットは破棄されてしまう。そのため、まずは、BGPで経路情報を取得して疎通できる状態にしてから、VRRPを動作させる。
そうすることで、VRRP設定時に意図せずR13がマスタに昇格しても疎通を続けられるというわけである。
*VRRP設定作業では、障害が起きていなくてもR13が一瞬(または恒久的に)VRRPマスタになることがあるので、念には念をという観点でこの順番をとる。
(5)確認事項:パケットロスが発生しないこと① [送信元:R13 宛先:FW10] or [送信元:FW10 宛先:R13] or [送信元:R13 宛先:R11] or [送信元:R11 宛先:R13] ② [送信元:R14 宛先:R13] or [送信元:R13 宛先:R14]

確認事項:パケットロスが発生しないこと。
確認事項としては、pingが一発届くだけでなく、しっかりと連続で届くことを確認する。そうすることでパケット落ちが発生してないかという回線・機器の品質を確かめられる
① [送信元:R13 宛先:FW10] or [送信元:FW10 宛先:R13] or [送信元:R13 宛先:R11] or [送信元:R11 宛先:R13]
LAN側の確認をしている
② [送信元:R14 宛先:R13] or [送信元:R13 宛先:R14]
WAN側の確認をしている
(7)① R11② R13③ R11 と R12 とを接続する回線④ R13 と R14 とを接続する回線⑤ R11 と L2SW10 とを接続する回線⑥ R13 と L2SW10 とを接続する回線
これは新規導入による疎通確認テストではない。あくまでも障害試験である。
障害試験とは稼働中のシステムに対して、あえて意図的に障害を起こし、裏のルートに切り替わるかを確認すること。
よって、今回の目的はマルチホーミングなので既存のR11などもわざと障害を起こしてR13経路に切り替わるかを確認する必要がある。
設問3
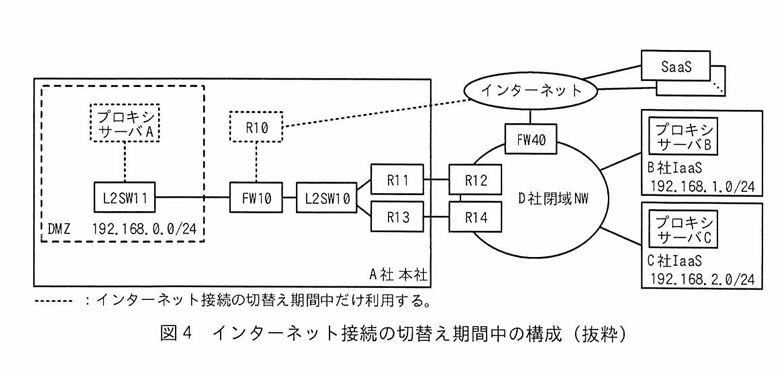
(1)ルーティングのループが発生する
では、1つ1つ現象を紐解いていこう!
Q.D社閉域NWの設定変更とは?

A.FW40にインターネット宛てのデフォルトルートを広告する設定である。これを設定することで、R12,R14へとインターネット宛ての経路が確立される
Q.FW10のデフォルトルートの設定変更を行うとは?また、どうなる?

A.FW10の変更とは、インターネット宛ての通信をR10からVRRPの仮想IP宛て(=D社閉域網宛て)に変えることを意図している。
Q.なぜループになるの?
A.上述した内容を念頭に置きつつループが発生するフローを見ていこう
▼ループのフロー
1.F10のルーティングテーブルにインターネット宛てをD社閉域網宛てにする(VRRPの仮想IP)
2.FW10にインターネット宛てのパケットが届くとR11に転送する
3.R11のテーブルではインターネット宛てはFW10となっているのでFW10へ送信する
4.TTLが0になるまで1~3を繰り返す=ループ
以上がループが起きる原因である。
では、次は逆にD社閉域網側のFW40にインターネット宛てのパケットを受け取る設定を入れた場合のフローを見ていこう!
▼正しい手順でインターネット宛てルートを設定した場合
1.FW40にインターネット宛てデフォルトルートを設定する
2.D社閉域網内のMP-BGPによりR12,R14にその経路が流れる
3.FW10側でもインターネット宛てはD社閉域網側に行くように設定する
4.実際のパケットがFW10に届くとR11に転送する
5.R11はR12からeBGPでインターネット宛ての経路を受け取っているのでR12に転送する
6.R12はFW40に転送する
7.FW40はインターネットへ流す
(3)送信元IPアドレスがプロキシサーバAで宛先IPアドレスがインターネットであった場合にネクストホップをR10とする設定
▼整理された全体フロー
- 特定部門(送信元IP制限のあるサービスを利用)
- 本文にもある通り特定部門にはプロキシAを案内し、ブラウザ等でプロキシAを設定してアクセス
- FW10がPBRによって「送信元=プロキシA」を検知し、ネクストホップをR10(旧ルート)へ強制転送
- 旧グローバルIPのままインターネットへ出るため、外部サービスのフィルタリングを無事クリア
- 一般部門(通常通信)
- DNSの自動制御(案2)によりプロキシBまたはCを参照
- FW10は通常通りデフォルトルートに従い、D社閉域網(新ルート)へ転送
- D社閉域網を通ってFW40(新グローバルIP)でNAPT変換され、インターネットへ出る
▼PBRの例
access-list 1 permit プロキシAのIP サブネット

route-map ルートマップ名 permit シーケンス番号
 match ip address 1
 set ip next-hop R10のIP

interface プロキシとつながっているインタフェース名
 ip policy route-map ルートマップ名
p.2 Q.IaaS(Infrastracture as a Service)って何?
A.IaaSとは、インフラをクラウド上で利用できるサービスのこと。つまり、自社内に電源、サーバーラック、LANケーブル、ネットワーク環境などの手配をする必要がなくなるということ。しかし、その上で動作するOS、アプリ、FWルールなどはすべて自分でやる必要がある。
p.2 Q.閉域網ってなに?
A.閉域網とはインターネットとは隔絶された独自のネットワーク。主にMPLSサービスなどが代表例としてある。これを使うことによって、閉じた空間なのでプライベートIPアドレスを広告して、離れた拠点間とのプライベートIPアドレス同士の通信ができるようになったりする。
Q.閉域網とインターネットVPN(IPsecなど)の違いは?
正直、閉域網でできることってインターネットVPNでも実現できるよね?暗号化して、カプセル化をすれば離れた拠点でもプライベートIP同士の通信ができるよね。じゃあ、なんで今も閉域網サービスは存在しているの?
A.結論から言うと、現代において企業がインターネットVPNではなく閉域網を選ぶ最大の理由は「通信品質の保証(SLA)」と「回線の信頼性・安全性の確保」にある。現代のインフラ観点でのポイントを比較表でまとめよう。
| 比較項目 | 閉域網 (IP-VPNなど) | インターネットVPN (IPsec) |
| 回線の実体 | 通信事業者の専用ネットワーク | 公衆インターネット |
| 品質・帯域 (SLA) | 保証あり(揺らぎ・遅延がほぼ無い) | ベストエフォート(混雑時に遅延・バースト発生) |
| ルーティング | 事業者網内でプライベートIPを直で交換可能 | インターネット上にTunnelを掘ってGRE/IPsec等で交換 |
| 暗号化処理 | 不要(物理的・論理的に隔離されているため) | 必須(途中の盗聴を防ぐため) |
| オーバーヘッド | ほぼゼロ | 暗号化+ESPヘッダー追加によるパケット長増大 |
Q.IaaSと閉域網の連携は誰が負担するの?

A社側がIaaS上で自分でD社と契約処理をしているのか、はたまた、B社がサービスとしてあらかじめD社の閉域網を利用できる形式を整えてくれているのか?だれが何をやっているのかを明確にしたい。
A.結論から言うと、費用や契約の最終的な負担者は「A社」だが、D社閉域網とB社IaaSの間の物理的・論理的な接続ライン(相互接続)自体は、B社とD社(事業者同士)があらかじめ準備して連携しているものになる。
▼各プレイヤーの役割と負担
- B社(IaaS)と D社(回線事業者)の関係
- あらかじめB社のデータセンターとD社の閉域網(MPLS網)を大容量の回線で相互接続(ピアリング)しておく。
- これにより「D社の閉域網を使っている顧客なら、インターネットを経由せずに直接B社IaaSにアクセスできる準備」が整っている。
- A社(利用企業)の契約と費用負担
- 費用を支払うのはすべてA社。
- A社は ①D社に対して「自社〜B社IaaS間の閉域網利用オプション料金」 を支払い、②B社に対して「閉域網接続用ポート(専用線ゲートウェイなど)の利用料」 を支払って設定を行う。
Q.もし、IaaSがサポートしていない閉域網を自社で使っていたら?
IaaSはサービスとして閉域網をあらかじめ接続準備してくれている。しかし、もし、自社で使っている閉域網がIaaSではサービス対象外であった場合、自分で接続処理などをしなくてはならないの?また、それはどうやってやるの?
A.「IaaS側で自社の閉域網が直接サポートされていない場合、中間事業者(マルチクラウド接続事業者)を挟んで繋ぐ」というのが、現代のエンタープライズネットワークにおける標準的な解決策。
Q.どうやって繋ぐのか?(解決策:中間事業者の利用)
そこで登場するのが、Equinix(エクイニクス)やMegaport(メガポート)といったデータセンター/マルチクラウド接続事業者(データエクスチェンジ事業者)。
▼接続のイメージ
- 自社〜中間事業者:既存の閉域網(D社)を中間事業者のデータセンターまで伸ばして接続する。
- 中間事業者〜IaaS:中間事業者はすでに主要なIaaS(AWS, Azure, GCP等)すべてと大容量の専用線で直結している。
- データ転送:中間事業者の拠点でパケットを折り返し、自社の閉域網からIaaSへ通信を流し込む。
Q.っつか、じゃあ中間事業者をメインの閉域網として使えばよくね?
A.完全にその通りで、実際に多くの企業がそのような構成(自社拠点〜中間事業者〜各クラウド)へ移行している。中間事業者の内部ネットワークも閉域網として運用されているので、乗り換えても閉域網として維持できるので問題ない。しかし、運用・契約上の都合などによって従来の閉域網を残す理由もある。
▼従来の閉域網(D社等)を残す主な理由
- ラストワンマイル(物理回線)の調達能力
中間事業者(Equinix等)は「都市部のデータセンター内」に拠点を持っている。全国にある自社オフィスや工場からそのデータセンターまで物理的な回線を引いて連れてくる役割(アクセス回線)として、キャリア(D社等)の網が必要になる。 - 長年の契約とコスト・移行リスク
すでにD社と長期契約(数年単位の割引等)を結んでいたり、全国数十拠点の設定変更・乗り換え工事に膨大なコストとリスクがかかるため、既存網を活かしたままクラウド接続部分だけを追加・拡張するケースが多く存在する。
p.3 A社の静的経路制御とは?

スタティック設定にしていると記されているが、具体的にどの機器でどんなスタティック設定をしているのか?現在の構成(図1)を見ると、通信の行き先は主に3パターンしかないので、それらを見ていこう!
- 本社PCから営業所やIaaSへ行く通信
- L3SW10:物理的にFW10にしかつながっていないので、ネクストホップはすべてFW10になる
- FW10:FW10は「
192.168.1.0/24(B社IaaS)や営業所宛てのパケットが来たら、ネクストホップ(次の送り先)を R11 に向ける」というスタティック経路を手動で書き込んでいる。
- 本社からインターネットへ行く通信
- L3SW10:物理的にFW10にしかつながっていないので、ネクストホップはすべてFW10になる
- FW10の設定:「デフォルトルート(
0.0.0.0/0:どこにも該当しない外向けの通信)は R10 に向ける」というスタティック経路を設定している。
- 営業所から本社やIaaSへ行く通信
- R20(営業所ルータ)の設定:「本社やIaaS宛て、あるいはインターネット宛ての通信はすべて D社閉域網(R21) に向ける」というスタティック経路を設定してる。
p.3 “開発サーバをシステム部が構築”って具体的に何をやっているの?
A.開発担当者には、あたかも「物理サーバがすぐそこにある」という状態で渡したい。そのために以下の設定が必要になる。
*ちなみに、「開発サーバ」とはシステムを開発するためのサーバ。このサーバ上で多くのトライ&エラーやりながら開発を進めていく。「テストサーバ」は開発サーバである程度形になったものの挙動をテストするためのサーバ。このテストサーバ上で、コードの修正などは基本的に実施しない。
▼構築
- インフラリソースの手配:B社IaaS上で仮想マシン(VM)を作成(CPU・メモリ・ディスク容量の割り当て)
- ネットワーク・IP設定:社内からアクセスできるようにプライベートIPアドレス(
192.168.1.x)を付与し、ルーティングやFW/セキュリティグループを設定
*開発担当者に直接仮想サーバを作らせると、内部でIPアドレスの重複が起きたり、セキュリティ設定が甘くなったりして、踏み台にされてしまうリスクがある。そのため、システム部門で一元管理している。 - OSのインストール・初期設定:LinuxやWindows ServerなどのOSを導入し、セキュリティパッチの適用や最低限のアカウントを作成
▼引き渡し
- アクセス用情報の提供:「IPアドレス(またはホスト名)」「管理用アカウント(管理者IDと初期パスワード、またはSSH秘密鍵)」を担当部門に通知する。
- 利用環境の案内:「社内PCからSSHやリモートデスクトップ(RDP)でアクセスして開発に使ってください」と伝達する。
▼引き渡し後
引き渡された後、開発サーバBの中で何をするかは担当部門(現場のエンジニア)の責任になります。
- ミドルウェア・開発環境の導入:Webサーバ(Apache/Nginx)、データベース(MySQL等)、PythonやJavaなどのプログラミング言語環境のインストール
- ソースコード・アプリの配置:開発するシステムのプログラムを入れて動かす
- 日々の運用管理:アプリのログ管理、開発メンバー用のアカウント追加・削除、不要になった際のシャットダウンや再起動
p.3 サーバがプロキシを使うとは?
プロキシを使う対象として、ブラウザとサーバが挙げられている。ブラウザはわかるけど、サーバにプロキシを指定って。。。どのサーバのこと?
A.開発サーバにはどのプロキシを使うかの設定が必要。APIやライブラリなどと連携するときにインターネットからそれらの情報を取得したりする必要があるので開発サーバにもプロキシ設定は必要。
Q.NAPTとは?
NAPT(IPマスカレード)とは送信元IPアドレスに加え「送信元ポート番号」も一緒に変換することで、1つのグローバルIPを複数の内部機器で同時に共有できるようにするアドレス変換技術。
▼NAPT雑学
ポートは216、つまり総数は65,536個。その中の0~1023はウェルノウンポートとして予約されている。つまり、1つのアドレスで表現できる総数は、65536-1024=64,512個となる。
▼NAPT実装コマンド
①インターフェースの内外(inside/outside)を指定
②内部から外部への変換対象を定義(アクセスリスト)
③NAT/PATを有効化するコマンドを設定
④確認・検証
#1.インターフェースの内外(inside/outside)を指定
Router(config)# interface GigabitEthernet0/0
Router(config-if)# ip address 192.168.1.1 255.255.255.0
Router(config-if)# ip nat inside
Router(config-if)# exit

Router(config)# interface GigabitEthernet0/1
Router(config-if)# ip address 203.0.113.1 255.255.255.0
Router(config-if)# ip nat outside
Router(config-if)# exit

#2.変換したい内部ネットワーク(送信元アドレス範囲)を指定
Router(config)# access-list 1 permit 192.168.1.0 0.0.0.255

#3.パターン1(プールを使わない場合)
Router(config)# ip nat inside source list 1 interface GigabitEthernet0/1 overload

#3.パターン2(プールを使う場合=グローバルIPが複数ある場合)
Router(config)# ip nat pool MYPOOL 203.0.113.10 203.0.113.20 netmask 255.255.255.0
Router(config)# ip nat inside source list 1 pool MYPOOL overload

#4.確認
#現在の変換テーブルの確認
Router# show ip nat translations
#NATの統計情報(ヒット数、インターフェース設定など)を確認
Router# show ip nat statistics
Q.キャッシュDNSサーバのフローはどうなってる?
1. PC ➔ キャッシュDNSサーバ
- PCはDHCP等で知らされた「キャッシュDNSサーバのIP」宛てに名前解決要求(53番ポート宛て)を送信する。
2. キャッシュDNS ➔ ルートDNSサーバ(1段階目)
- キャッシュDNSはあらかじめ保持している「ルートヒント」からルートDNSのIPを選ぶ。
- パケット:送信元=[キャッシュDNSのIP : ランダムなポートA] ➔ 宛先=[ルートDNSのIP : 53]
- FW10のNAPT:送信元を「FW10のグローバルIP : ランダムなポートB」に動的NAPT変換して外へ送出。
- 応答:ルートDNSから「.jp を管理するTLDサーバのIPアドレス」が返ってくる。
3. キャッシュDNS ➔ TLD(.jp)DNSサーバ(2段階目)
- 同様に、ランダムな送信元ポートを使ってTLDサーバへ問い合わせる。
- 応答:TLDサーバから「co.jp を管理するDNSサーバのIPアドレス」が返ってくる。
4. キャッシュDNS ➔ 権威DNSサーバ(3段階目)
- 最終的に
example.co.jpを管理する権威DNSサーバへ問い合わせる。 - 応答:権威DNSから
www.example.co.jpの最終的なIPアドレス(例:192.0.2.1)を取得する。
5. キャッシュDNS ➔ PC
- 取得したIPアドレスをPCに回答し、同時にその結果を一定時間(TTL)自身の中にキャッシュ(保存)。
Q.DNSSECとは?
DNSSECとはキャッシュポイズニングを防止する技術の一つ。では、フローを見ながら理解していこう!
ステップ1:レコード自体の検証(ZSKを使用)
- 対象:Aレコードなど
- 検証:権威DNSから取得したDNSKEYレコード内の ZSK(ZoneSigningKey)公開鍵 を使い、Aレコードに付いている RRSIG(Resource Record Signature) を検証する。
*RRSIG(A)は権威DNSがAレコードから生成したハッシュ値をZSK秘密鍵で暗号化したもの。
*検証するときは検証側がZSK公開鍵で署名を復号し、出てきたハッシュ値と検証側でも生成したハッシュ値が一致することを確認する。 - 結果:Aレコードが改ざんされていないことが判明。
ステップ2:ZSK公開鍵の検証(KSKを使用)
- 対象:ZSK公開鍵が含まれる「DNSKEYレコード」
- 検証:権威DNSから取得した KSK(KeySigningKey)の公開鍵 を使い、DNSKEYレコードに付いている RRSIG(DNSKEY) を検証する。
- 結果:ZSK公開鍵が本物であることが判明。
ステップ3:KSK公開鍵の検証(親ゾーンと連携)
- 対象:KSK公開鍵
- 検証:
- 親ゾーン(例:
.jp)へ問い合わせて DSレコード(Delegation Signer)(=子ゾーンのKSK公開鍵のハッシュ値)を取得する。 - 手元にあるKSK公開鍵を自分でハッシュ化し、親からもらったDSレコードと一致するか比較する。
- 親ゾーン(例:
- 結果:KSK公開鍵が親ゾーンによって保証された本物であることが判明。
p.5 プロキシサーバを動的に切り替える方法は?

案1を見ると、障害が起きるとプロキシCを使いたい旨の記載がある。では、具体的にどうやっているのか?
1.DNSを変更している
DNSでFQDNに対するIPアドレスをBからCのアドレスに変更すれば、必然的にCのプロキシが使われることになる。
2.PACファイル
PACファイルだと動的にクライアント側が宛先を変更できるため、以下のような設定をすればプロキシCが使われる。
#通常時はproxybで名前解決されるが障害が起きると、2つ目のproxycが利用される。
return "PROXY proxyb.a-sha.co.jp:8080; PROXY proxyc.a-sha.co.jp:8080";
p.7 Q.マルチホーム環境でも静的経路で対応できるのでは?

結論から言うと、「FW10でIP SLA+スタティック制御を行う」というアイデアは、A社から出ていく通信(往路)だけを見れば動くように思えるが、実際のネットワーク構築(特に復路通信、プロバイダ連携、運用性)においては致命的な欠陥が4あり、採用できない。
・復路を制御できない
例えば、R11とR12間をFW10がIP slaで監視したとする。そして、経路に障害が起きたらサブルートであるR13とR14の経路を優先させる静的ルートを設定しておく。これだと、A社側からの通信はR13経由にできる。しかし、外部からはR11とR12間で障害が起きていることを知らないので、R12宛ての経路が届いてしまう。。
では、仮にR12でip slaを稼働させR11とR12を観察し、その結果をMP-BGPでD社閉域網に流すという方法であれば実現できなくもない。(トラッキングで当該ルートを削除。→RIBから情報が消える→BGPの参照先であるRIB当該経路が消えたことを検知→BGPでwithdrawを流す)
しかし、それは現実的じゃない。というか、そもそも、そのような動的に経路を変更したりできるものが動的なルーティングプロトコルである。なので、経路が複数ある場合は基本的に静的ではなく動的なルーティングプロトコルの制御を使うのがベターとなる。
Q.VRRPとは?
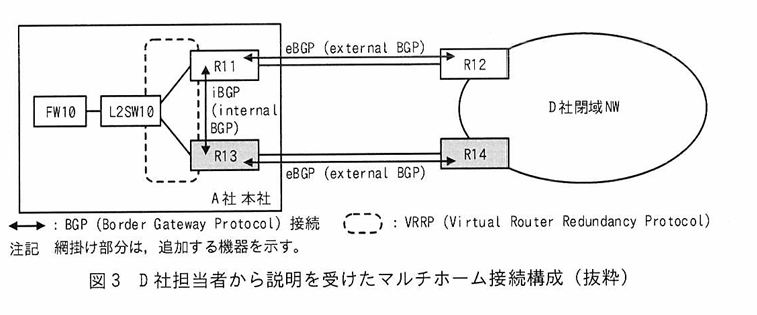
VRRP(VirtualRouterRedundancyProtocol)とはデフォルトルートを冗長化するためのプロトコル。複数のルータを1つのルータのように振舞わせることで、1台が故障してもほかのルータで通信を継続させることができる。
▼障害検知方法
マスターが1秒ごとにマルチキャスト224.0.0.18宛てにAdvertisementを送る。これがタイムアウト時間届かないと、バックアップは障害と検知して仮想IP/仮想MACを引き継ぎGARPを送信する。
▼FHRP(First Hop Redundancy Protocol)とOSPF
| プロトコル | 主系(稼働側) | 副系(待機側) | 補足・その他の役割 |
| VRRP | Master | Backup | 標準規格(RFC)。 |
| HSRP | Active | Standby | Cisco独自。standby コマンドで設定。 |
| GLBP | AVG (Active Virtual Gateway) | SVG (Standby Virtual Gateway) | Cisco独自(負荷分散型)。転送担当は AVF (Active Virtual Forwarder)。 |
| OSPF | Master | Slave | 冗長化ではなく、DBDパケット同期(ExStart状態)時の制御関係。 |
p.8 Q.専用線で接続するとは物理的にどうやっているの?
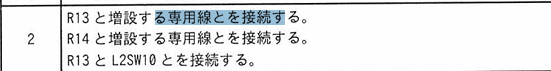
A社からD社まで直通の超長いケーブルを1本物理的に引っ張るわけではない。通信事業者(NTT等)がすでに地下や電柱に張り巡らせている既存の光ファイバー網(インフラ)を活用し、両端の拠点へケーブルを引き込んで接続している。
Q.物理的にどう繋がっているのか?
A社本社のR13からD社網のR14までは、以下の3つの区間で物理的につながっている
- 1.A社側の引き込み(ラストワンマイル)
①電柱やビル地下のクロージャから通信事業者の光ファイバーの先端とA社側ケーブルの先端をつなぐ。
②A社側のもう一方の先端は端子盤につなぐ
③端子盤とONU(光回線終端装置)をつなぐ
④ONUが光信号を電気信号に変えてR13につなぐ - 2.通信事業者のビル間ネットワーク(中継網)
①A社から引き込んだ光信号は、最寄りのNTT等の基地局(収容局)へ入る。
②ここから先は、地下に埋まっている既存の巨大な光ファイバー網を通じて、D社最寄りの基地局まで運ばれる - 3.D社側の引き込み
A社側と同様に、D社拠点(R14側)のビルにも光ファイバーが引き込まれ、D社側のONUに繋がる
p.8 Q.なぜBGPをすぐに確立しないの?また、それは技術的に可能なの?

A.「BGP設定を入れてもセッションを確立させない」ことは技術的に可能。また、一括して確立させない理由は設定途中の「中途半端な状態」での経路流入事故を防ぐため。
要は、手動で1行ずつ設定していくと、行と行の間で数秒間経過してしまい、その間にフィルタリングをする前に情報が流入・流出してしまうのでそれを防ごうねということ。
確立させない方法
BGPの設定コマンドの中に neighbor <IPアドレス> shutdown という命令を書いておく。 これを書いておくと、設定自体はルータに保存されるが、相手(ピア)へBGPの接続要求(OPENメッセージ)を送らなくなる。
#無効化させるとき
neighbor <IPアドレス> shutdown

#有効化させるとき
no neighbor <IPアドレス> shutdown
Q.即座にBGP起動するとどういう不具合があるの?
1. フィルタ未設定による「ルートリーク(経路の誤流出)」
BGPの設定手順は、コマンドの構造上「相手と繋ぐ設定(neighbor)」を投入した後に、「外に流す経路を絞り込む設定(prefix-listやroute-map)」を書き込む流れになる。
即時接続させてしまうと、絞り込み設定を打ち込むまでのわずか数十秒の間に、社内ネットワークの不要な経路が外部(D社網)へ一気に漏洩(リーク)する。流出した経路の量によっては、D社側のルータの防御機能(Prefix Limit)が作動し、回線を自動遮断される恐れがある
2. 接続の不整合による「ブラックホール(パケット吸い込み・破棄)」
たとえば、先に「R13 ⇔ R14(WAN側)」のBGPだけが繋がり、「R13 ⇔ R11(社内iBGP)」の設定がまだ完了していない時間が発生したとする。
- 行き:D社側(R14)は「R13経由でA社に行ける」と認識し、データ(パケット)をどんどん送り込んできます。
- 戻り:しかしR13側は、社内のR11との連携(iBGP)がまだできていないため、届いたパケットを社内へ流せず、そのまま捨ててしまう(通信断)。
3. 経路のバタつき(フラッピング)による既存通信の瞬断
4台のルータがバラバラのタイミングでBGPを繋ぎ始めると、各ルータは不完全な情報をもとに「どのルートが最適か」を何度も再計算する。その結果、現在正常に動いている「R11 ⇔ R12」の既存ルートまで経路が頻繁に切り替わり(フラッピング)、現在稼働中の業務通信に遅延やパケットロスなどの悪影響を与えてしまう。