設問1
(1)a: リバース b: 権威 c: キャッシュ d: ストリーム e: :method f: TLS
a: リバース
インターネット側のクライアント(利用者)から見ると、アクセス先はDMZにある「Webサーバー」に見える。しかし、Webサーバーは自分で処理を完結させず、内部の「APサーバー」に処理を中継・肩代わりさせている。つまり、外部からのリクエストをサーバー側(Webサーバー)が代理で受け止めて内部に流している構造なので、これはリバースプロキシになる。
Q.フォワードプロキシとリバースプロキシの違いは?
フォワードかリバースかを判別する基準は、「どちら側の世界を守るため、またはどちら側の代理としてそこに立っているか」である。
- フォワードプロキシ(順方向)
- 誰のための代理か: クライアント側
- 目的: 社内などのクライアントが、インターネットへアクセスするときに経由する。クライアントのIPアドレスを隠したり、アクセス制限をかけたりする。
- リバースプロキシ(逆方向)
- 誰のための代理か: サーバー側
- 目的: インターネット上の不特定多数のクライアントからのリクエストを、本当のサーバー(WebやAP)の代わりに「真っ先に受け止める」。サーバーの保護や負荷分散を行う。
C: キャッシュ
キャッシュDNSサーバの別名には「フルサービスリゾルバ」、「再帰DNSサーバー」、「リカーシブDNSサーバー」などがある
e: :method
HPACKには4つの必須フィールドがある。:method、:scheme、:authority、:pathである。その中の:methodを記入すればよい。正直:authorityでも正解になる気がするが。。。安牌な:methodを入れておこう!
f: TLS
ALPNはどのプロトコルの拡張か?が聞かれている。ALPNはTLSを拡張したものであるので回答にもTLSを記載する。
Q.SSLやSSL/TLSという回答ではだめなの?
SSLは既に撤廃されているプロトコルなのでSSLと記載するのはNG。また、SSL/TLSは、暗号化通信全体を指す慣習的な総称として呼ばれることもあるが、テストなどの厳格な場ではTLSのみを使うことが望ましい。
設問4
(1)回答は以下の図を参照
| 機器 | 宛先ネットワーク | ネクストホップ |
| L3SW | ア:172.21.10.0/24 | イ:172.21.11.2 |
| 仮想ルータ | 0.0.0.0/0 | ウ:172.21.11.1 |
ア:172.21.10.0/24、イ:172.21.11.2
G社データセンター側からJ社クラウド側(172.21.10.0/24)に行きたいパケットは、まず仮想ルーター(172.21.11.2)に投げろという指示をあらわしている。
ウ:172.21.11.1
▼APサーバが使われるフロー
1. リクエストの到着(インターネット ➔ 仮想LB ➔ Webサーバ)
①クライアントがインターネットからJ社クラウドの仮想LBにアクセスする。
②仮想LBが負荷分散として、VPCセグメント内のいずれかのWebサーバにリクエストを転送する。
2. 動的コンテンツの判定とG社DCへの転送(Webサーバ ➔ 仮想ルーター ➔ 専用線 ➔ L3SW ➔ APサーバ)
①Webサーバがリクエストを受け取るが、それが「画像などの静的ファイル」ではなく「プログラム処理が必要な動的コンテンツ(例: データベースのデータが必要など)」であると判断。
②Webサーバ自身にはその処理能力がない(あるいはAPサーバに処理を投げなければならない)ため、G社データセンター側にあるAPサーバへリクエストを転送しようとする
*WebサーバからAPを使うと判断するときは、宛先APサーバがプログラムでハードコーディングされていることが多い。
③このとき、VPCセグメント内からデータセンター側へ行くためには、ネットワークの出口である仮想ルーターにパケットを渡す必要がある。
*ここで使われるのが空欄ウのデフォルトルート。でも正直、デフォルトルートにしなくてもAPサーバのサブネットが特定できるなら、当該サブネットを指定すればいい。わざわざデフォルトルートにする必要がない。
④仮想ルーターは、専用線を経由してG社データセンター側のL3スイッチにパケットを送り、L3スイッチからAPサーバにリクエストが届く。
3. 処理結果の返却(APサーバ ➔ L3SW ➔ 仮想ルーター ➔ Webサーバ ➔ 仮想LB ➔ クライアント)
①APサーバが処理を行い、その結果(動的データ)をL3スイッチに返す。
②L3スイッチから専用線を通って、J社クラウド側の仮想ルーターに戻ってくる。
③仮想ルーターから、最初にリクエストを投げたWebサーバにデータが返される。
④Webサーバが最終的なレスポンスを仮想LBへ返し、仮想LBを経由してインターネット上のクライアントに届く。
(2)動作モード:アプリケーションモード 理由:HTTP/2リクエストをHTTP/1.1に変換して負荷分散するから
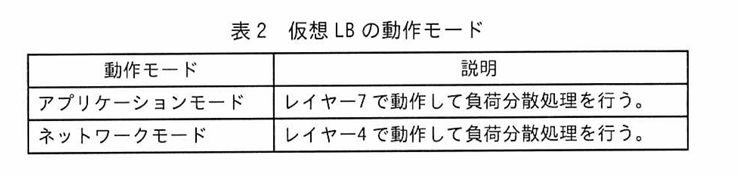
ネットワークモードだと、パケットのL3,L4までしか見ないのでL7でどのプロトコルを使っているかまでは見ない。要は、変換対象としてL3、L4レベルしかできない。
一方、アプリケーションモードは変換対象にL7まで含めることができるのでHTTP/2をHTTP/1.1に変換できる。
問題文中の「負荷分散処理」というとあたかも宛先のみを動的に変換対象とするというイメージだが、そうじゃなくて、どこまでも変換対象にするのかを意味している。
Q.HTTPって何?
HTTPってWebサーバとやり取りするときに使うプロトコルってイメージはあるけど、意外とそれ以上深くは知らないかも。。。。ということでそもそもHTTPってなんなの?という疑問を解消していこう!
A.HTTP(HyperText Transfer Protocol)とは、インターネット上でWebブラウザ(クライアント)とWebサーバーの間で、文字や画像、HTMLファイルなどのWeb情報をやり取りするための「共通のルール(プロトコル)」のことである
p.5 Q.構成変更後のDNS設定はどうなるの?
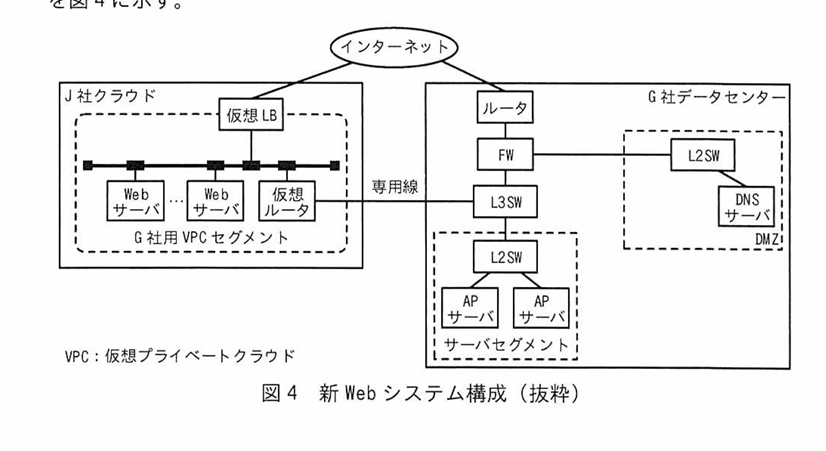
WebサーバをJ社クラウドに配置することによってDNSのレコードも変更する必要が出てくる。では、どのように変更すればよいのか。。。。それをシナリオとともに見ていこう!
▼前提条件
G社WebサーバのFQDNをshop.g-company.comとする
ステップ①:G社(自社)の権威DNSの変更
- 変更前:
G社WebサーバのFQDN(例:shop.g-company.com) に対して、G社データセンターにあったWebサーバーのIPアドレスをAレコードとして直接登録していた。 - 変更後: Aレコードを削除(または変更)し、CNAMEレコードを設定する。
- CNAMEに何を書くか: J社クラウドで仮想LBを作成した際に自動割り当てられる「仮想LBのFQDN(例:
xxx.j-cloud-provider.com)」を指定する。
ステップ②:ユーザーからの名前解決要求
- ユーザーのWebブラウザが
shop.g-company.comにアクセスしようとする。 - ユーザーのPCは、G社の権威DNSに対して
shop.g-company.comのIPアドレスを問い合わせる。 - G社の権威DNSは、「それはJ社の仮想LB(
xxx.j-cloud-provider.com)を見てね」とCNAMEの情報を返す。
ステップ③:J社側での名前解決
- 案内を受けたユーザーのPC(フルリゾルバ)は、今度はそのJ社側のFQDN(
xxx.j-cloud-provider.com)のIPアドレスを調べるために、J社側のDNSへ問い合わせる。 - J社側のDNSが、その時点での仮想LBの正しいIPアドレスを返答する。
ステップ④:通信の開始と仮想LBによる振り分け
- ユーザーのブラウザは、手に入れた仮想LBのIPアドレス宛てにHTTP/2などでリクエスト(パケット)を送信する。
- J社の仮想LBがそのリクエストを真っ先に受け取り、「これは静的コンテンツだからクラウド内のWebサーバーへ」「これは動的コンテンツだからG社データセンターのAPサーバーへ」という風に、URLや設定に応じて適切にルーティング(振り分け)を行う。
Q.:method,:path,:schemeとかって何なの?
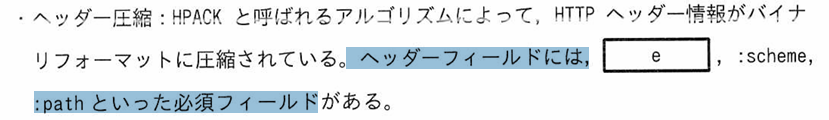
従来、リクエスト情報(例:https://example.com/index.html)は1行にまとめて書かれていた。それをHTTP/2では:method や :path、:scheme、:authority という個別のヘッダーフィールドにバラして表現するようになった。
▼各フィールドの解説
:method
役割: サーバーに対して「何をしたいのか(どんな操作を要求するか)」を伝える指示書
主な種類:
GET:サーバーからデータを「取得」する(一番多い)
POST:サーバーにデータを「新規送信・登録」する
PUT / PATCH:サーバー上のデータを「更新・修正」する
DELETE:サーバー上のデータを「削除」する
:path
役割: サーバーの中にある「どのファイルやリソース(階層)にアクセスしたいのか」という宛先の場所を指定
具体例:
https://example.com/images/logo.pngというURLであれば、ドメイン(example.com)より後ろの部分である /images/logo.png がそのままパスになる。サーバーはこのパスを見て「あ、あの画像を欲しがっているんだな」と判断する
:scheme
役割: ご自身で気付かれている通り、「通信にどのプロトコル(約束事)を使うか」を表す最頭の部分
具体例:
URLの先頭にある https:// や http:// の「https」や「http」の部分が入る
Q.フィールドの必要性は?
正直、従来のように1行にまとめてリクエストしたほうが効率よくね?なんでわざわざフィールドに分けるの?そっちの方が返ってオーバーヘッドとかデータ量が多くなりそうじゃね?
A.非常に自然な疑問。しかし、実際はその真逆で、「分解して構造化するからこそ、HPACKで圧倒的に効率よく圧縮できる」ようになっている。
① 「文字列の重複」をディクショナリ(辞書)で極限まで削れるから
- HTTP通信では、同じサイトにアクセスする際、何度も何度も同じメソッド(
GET)や同じスキーム(https)、同じホスト名(:authority)を繰り返し送信する。 - HTTP/1.1の1行テキスト(例:
GET /index.html HTTP/1.1)のままだと、毎回この長い文字列をそのまま流すことになり、無駄が多くなる。 - 一方、HTTP/2で項目ごとに独立させると、HPACKの仕組み(裏側にあるあらかじめ用意された辞書や、動的に学習する辞書)によって、「
GETというメソッドは、インデックス番号の『2番』ね」「httpsは『7番』ね」というふうに、わずか数バイト(あるいは1バイト未満)の数字に置き換えて(あるいは参照して)送ることができるようになる。
② 「パス(:path)」以外の部分はほとんど毎回同じだから
- アクセスするたびに変わる可能性があるのは主に「パス(
:path=/images/a.pngや/index.htmlなど)」くらいで、:method(大体GET)や:scheme(https)、:authority(自社ドメイン)は、同じセッション内であればほぼ変わらない。 - 変わりにくい部分を独立したフィールドにしておくことで、2回目以降のリクエストでは「前と同じなので、共通の辞書番号だけ送るよ(実体の文字列は送らない)」という省略(差分圧縮)が強力に効くようになる。
③ バイナリ形式での高速処理
- テキストの文字列(
GET /index.html...)を毎回プログラムでパース(文字を切り貼りして解釈)するよりも、あらかじめ項目ごとに整理されたバイナリデータとしてやり取りした方が、サーバーやクライアントのCPU負荷が圧倒的に低く、高速に処理できる。
Q.ALPNってなに?
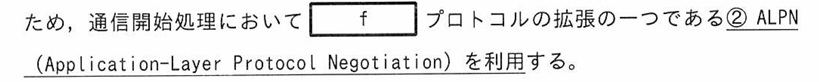
ALPN(Application-Layer Protocol Negotiation)とはTLSハンドシェイクのタイミングで「どのアプリケーションプロトコル使う?」と交渉するためのTLS拡張機能である。
Q.もしALPNがないと?
HTTP/2がほぼ使えなくなる。ALPNを使わないでHTTP/2を使おうとするとH2CとUpgradeヘッダーを利用すればHTTP/2に切り替えれなくもない。しかし、それらの機能はchromeなどの主要ブラウザではサポートされていない。つまり、実質的にHTTP/2を使いたい場合はALPNがほぼ必須とういことである。
HTTP/1.1を使いたい場合はALPNは不要。なぜならHTTP/1.1はデフォルトだから。
p.4 Q.h2って何?

h2とは、ALPNで「どのプロトコルを使うの?」というネゴシエーションの際にいちいち「HTTP/2」ですと答えると長いので、h2に略した識別子を使うためのもの