設問1
(1)a:ホスト or アドレス b:ICMP Unreachable c:3 d,e:メール中継サーバ、FPサーバ
a:ホスト or アドレス
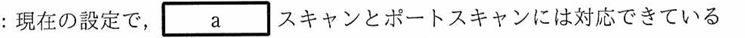
ホストスキャン(別名:アドレススキャン / IPスキャン / ピングスキャン)
目的: ネットワーク上に「生きて稼働しているホスト(IPアドレス)」が実在するかどうかを調べること。
やり方: ICMP (Echo Request/Ping) やTCP SYN、UDPパケットなどを特定のIPアドレス範囲にばらまき、応答があるかどうかを確認する。
▼PowerShellでのコマンド例
ping 192.168.1.1ポートスキャン
目的: 見つかったホストに対して、どのポート(サービス)が空いている(待ち受けている)かを調べること。
やり方: TCPのSYNパケットなどを各ポート番号(例: 25, 80, 443など)に送り、SYN/ACKが返ってくるかで稼働しているサービスを特定する。
▼PowerShellでのコマンド例
Test-NetConnection -ComputerName 192.168.1.10 -Port 80

#TcpTestSucceeded : True と表示されれば、そのポートが開いていて(サービスが待ち受けていて)通信可能
#False の場合は、ポートが閉じているか、FWなどで遮断されている
b:ICMP Unreachable
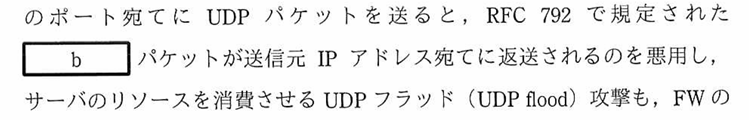
宛先ポートがクローズの場合は、ICMP Unreachableが届く。
d,e:メール中継サーバ、FPサーバ
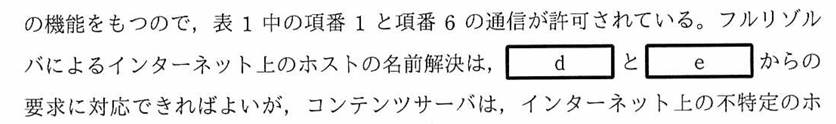
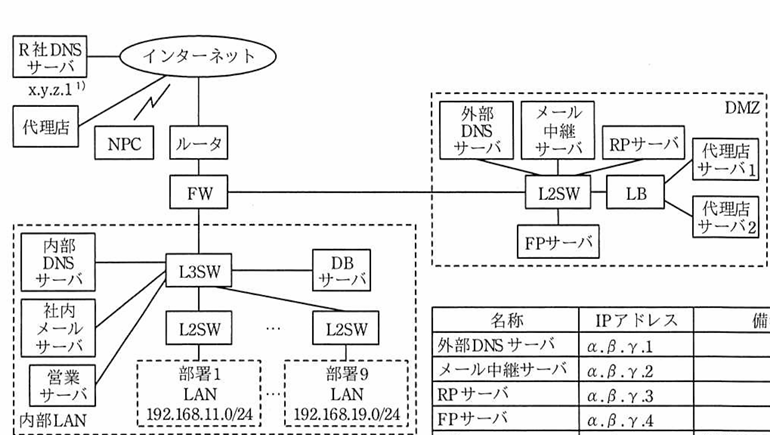
メール中継サーバにフルリゾルバ機能を許可する理由…
メール中継サーバは宛先のメールアドレスから当該ドメインのメールサーバを特定する必要がある。特定するには名前解決が必要なので、フルリゾルバ機能を許可してあげる必要がある。
FPサーバにフルリゾルバ機能を許可する理由…
FPサーバは、HTTPリクエストの終端となる。そして、ユーザからのHostヘッダフィールドをベースに宛先を名前解決して、そのうえでHTTP通信を始める必要がある。そのため、FPからの要求は許可してあげる必要がある。
内部メールサーバが回答にならないのはなぜ?…
内部メールサーバは、LAN内のメール中継はするが、ドメイン外の宛先を受け取ると問答無用で中継メールサーバに渡す。つまり、外部宛ては名前解決(IPアドレス特定)は不要だから、外部DNSサーバのリゾルバ機能を許可する必要がないということ
設問3
(1)ルータが受信したパケットの送信元IPアドレスが、ルーティングテーブルに存在しない場合、受信したパケットを破棄する
uRPF(unicast Reverse Path Forwarding)とは、ルーティングテーブルと受信パケットを比較して、悪意のあるパケットをフィルタリングする技術である。
ルーティングテーブルと整合性が取れるなら許可、取れないなら破棄というルールになる。
なお、uRPFにはStrictモードとLooseモードがある。今回の場合はLooseモードの特徴である「ルータが受信したパケットの送信元IPアドレスが、ルーティングテーブルに存在しない場合、受信したパケットを破棄する」が回答となる。
*uRPFについてスッキリ理解できない場合はこちらをクリック👈
Q.なんでLooseモードの説明が回答になるの?
企業ネットワークとISPの接続点や、インターネットの境界ルータで「ストリクトモード(送受信のインタフェース完全一致)」を有効にすると何が起きるか?
・インターネットの通信は往復で経路が異なる(非対称ルーティング)が頻繁に発生する。
・ストリクトモードを安易に入れると、「正規の正当な通信」までパケット破棄されてしまうトラブルが起きるため、ISP側が導入するuRPFは基本的に「ルーティングテーブルに経路が存在するかどうか」を見るルーズな動作が前提になりがち。問題文の「ISPの接続ルータ」という一言は、実はこうした背景を暗に含んでいる。
Q.uRPFを実現するコマンドは?👇
ip verify unicast source reachable-via rx
ip verify unicast source reachable-via any
ip verify unicast source reachable-via rx allow-default
ip verify unicast source reachable-via any allow-default
設問4
(4)インターネットから受信した、W社のメールアドレス宛て以外のメールは中継処理しない。
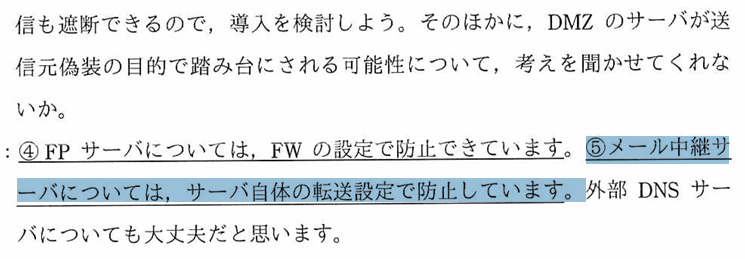
送信元偽装の目的で、踏み台にされることを防ぐにはどのような設定を講じたらよいか?という質問である。
Q.送信元偽装の目的って何?
プロキシサーバやメール中継サーバは、一旦セッションの終端として機能する。そして、再度パケットを再構成して実際の宛先にパケットを投げる。この仕組みが意味するのは、送信元IPアドレスが本来のユーザIPではなく、中継に使うメールサーバ・プロキシサーバのIPアドレスに変更されているということ。=送信元偽装が可能!ということ。
これが、👆「送信元偽装の目的で」の意味である。
Q.なんでFW側で設定しないの?
FPではFWの設定によって踏み台利用を防止していた。メール中継サーバでもFWでブロックすればいいじゃん?
A.FWでは中身の「宛先メールアドレス・送信元メールアドレス」は管轄外だから。FWはあくまでもL3,L4をメインとしたフィルタリング機能である。
以上より、メール中継サーバの設定は「インターネットから受信したW社のメールアドレス宛以外のメールは中継処理しない」となる。
*インターネットからというフレーズが大切。すべてとしてしまうと、内側からの中継も拒否されてW社PCがメールを送信できなくなってしまう。
設問5
(3)攻撃者が送信する、キャッシュポイズニングのための名前解決要求パケットはFWで破棄されるから
キャッシュポイズニング攻撃は以下の流れで実施される。
①ポイズニングしたいドメインを指定して攻撃対象DNSサーバに名前解決要求
②攻撃対象DNSサーバが当該ドメインの権威DNSサーバへ問い合わせ
③当該ドメイン権威サーバよりも早く、偽の応答を攻撃対象DNSサーバに返す
④宛先ポート・トランザクションIDが一致したら、正しい応答としてキャッシュに保存
以上のようになっている。しかし、W社は構成変更によってそもそも外部からの名前解決要求を受け取らない設定になっているので、上記フローの①がそもそも成立しなくなるキャッシュポイズニングを防げるのである。そのため、回答は「攻撃者が送信する、キャッシュポイズニングのための名前解決要求パケットはFWで破棄されるから」となる。
設問6
(1)e,g,h,f
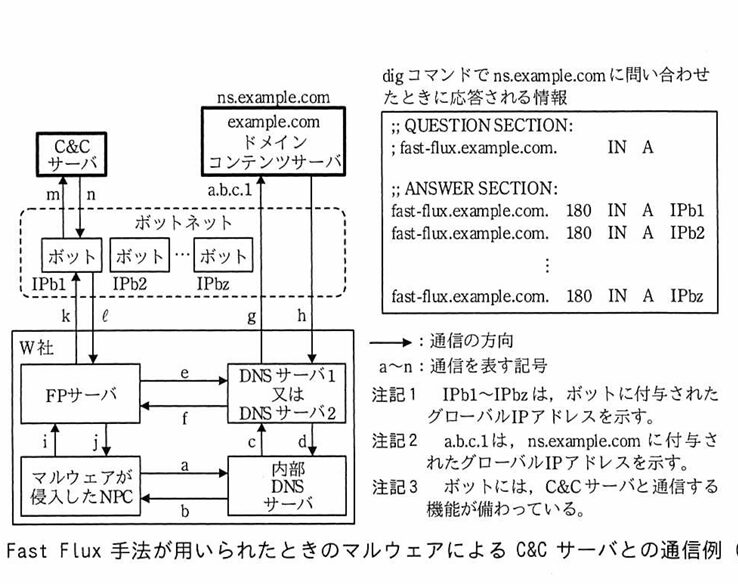
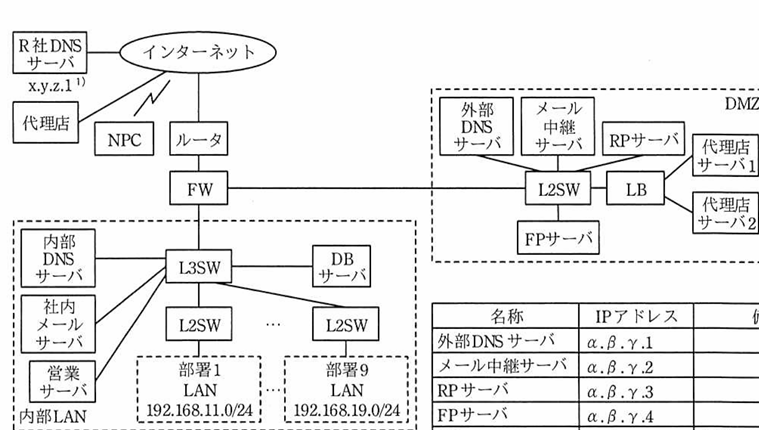
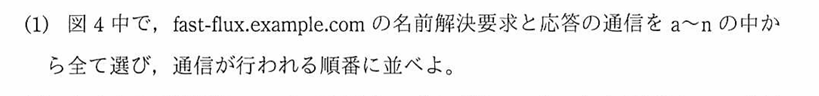
まず、回答を確認するとe,g,h,f、つまり「FP→DNSサーバ2(フルリゾルバ機能を有する)→(反復問い合わせ)→権威DNS→DNSサーバ2→FP」という流れである。
以下👇記述より、C&Cサーバとのやり取りはURLフィルタリングで防げると書かれている。URLフィルタリング=HTTP/HTTPSを使った通信であると判明する。
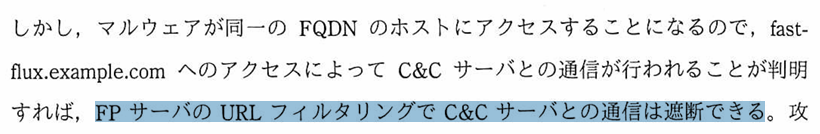
以上より、C&Cサーバとのやり取りはHTTP/HTTPSで実行される。HTTP/HTTPSを利用するときはFPを経由するので、名前解決もFPが実行すると導ける。
(3)アクセス先のホスト名をランダムに変更する
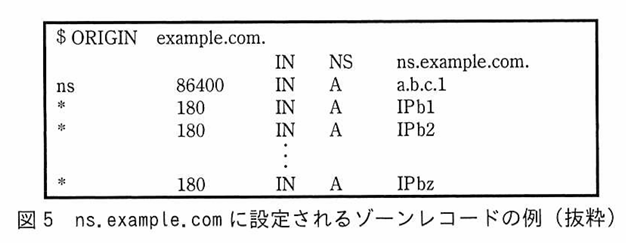
👆のようなゾーンレコードだと、なぜC&Cサーバの隠ぺいに寄与するのかが問われている。
▼フロー
1.マルウェアPCはDGA(Domain Generation Algorithm)で動的にドメインを生成する
2.1を名前解決
3..comまで行くと、example.com.の権威DNS(ns.exmple.com)を教えてくれる
4.ns.example.comにアクセスしてAレコードをもらいに行く
5.ns.example.comには、ワイルドカードマスク指定をしているので、デタラメなドメインにも対応可能
6.5の問い合わせに対して、ラウンドロビンでAレコードを返す
→アクセス先のボットを分散できる
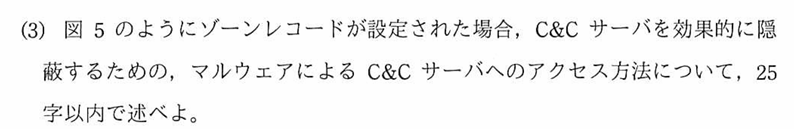
上記フローを念頭に置いた状態で、問題文を確認しよう。
マルウェアによるC&Cサーバへのアクセス時の工夫が問われている。マルウェア自身がやっていることは、上記手順の1の「DGAによってアクセス先のホスト名をランダムにしていること」である。そのため、回答がアクセス先のホスト名をランダムに変更するである。
よくある回答として「複数のAレコードを準備してアクセス先を分散させる」というのがある。しかし、これはあくまでもDNSサーバ側の工夫であって、マルウェアPCの工夫ではない。本問題はマルウェアPC側にフォーカスした質問なので、「DGA」の観点で答えてあげる必要がある。
(5)C&CサーバのIPアドレスが取得できないので、宛先が設定できないから
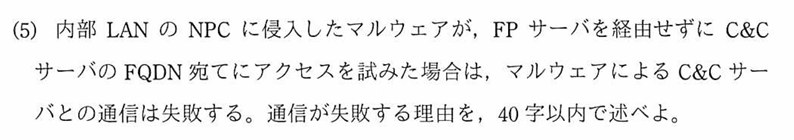
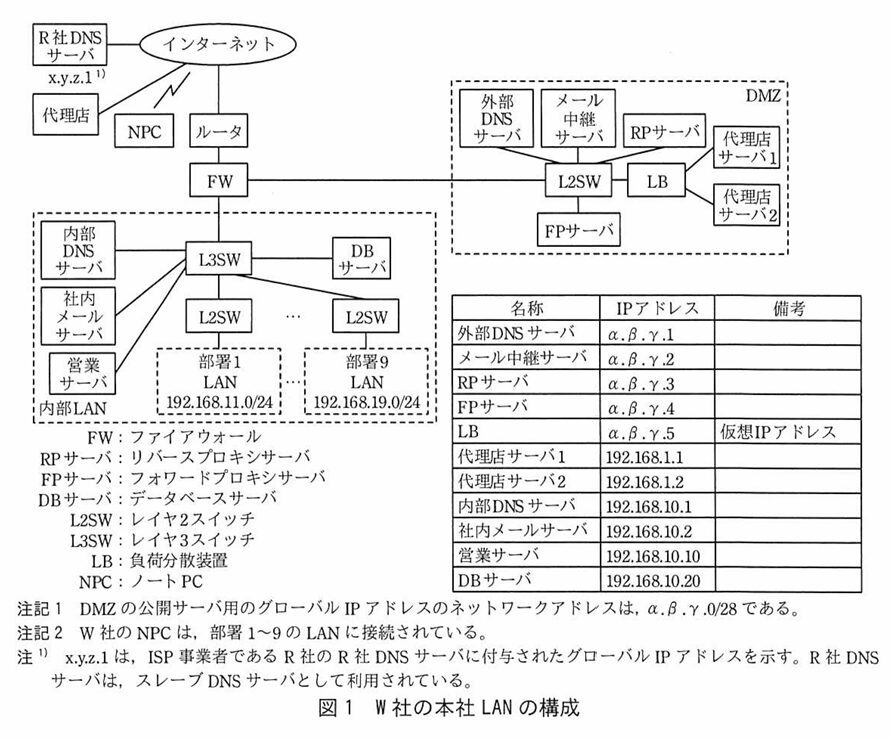
Q.なぜマルウエアPCはC&Cサーバの名前解決ができないの?
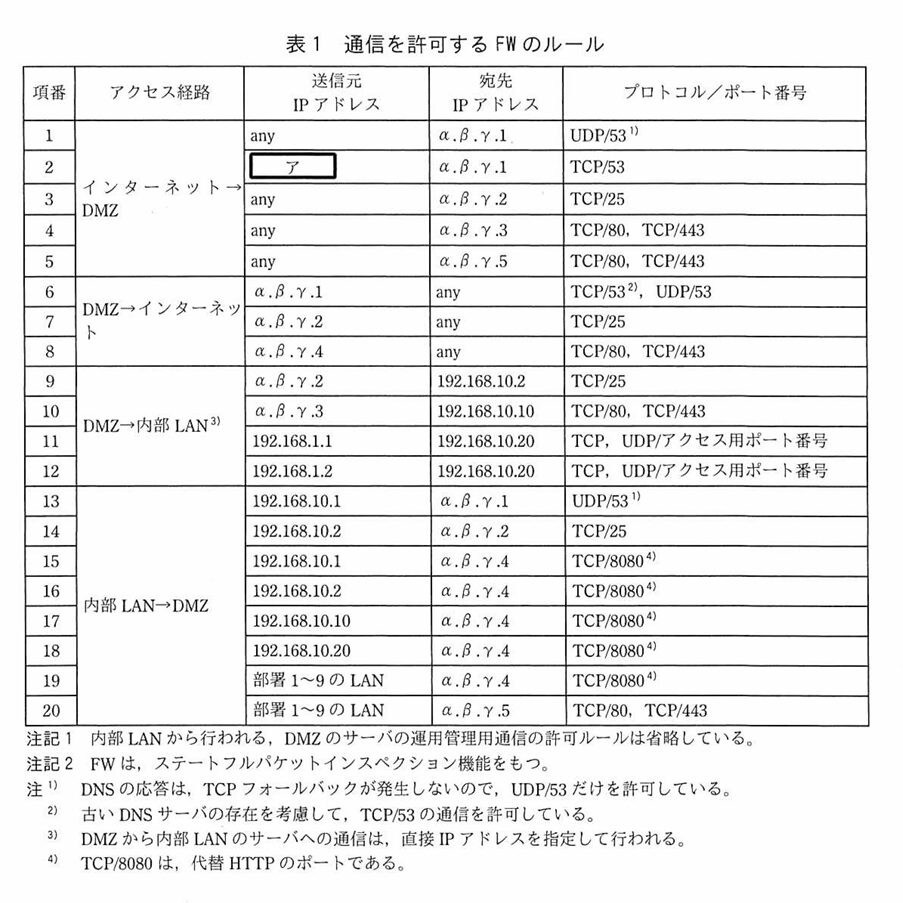
理由1.内部LANから外部DNSへ直接アクセスはFWの許可ルールにないから
理由2.内部DNS→外部DNS(α.β.γ.1)に問い合わせても、それはコンテンツDNSサーバとしてのDNSであるため、フルサービスリゾルバ機能を使った名前解決はしてくれない。
(W現環境ではメールとWeb通信以外の通信は内部LANからインターネットへ送ることができない)
Q.ファイル転送(FTP)や、独自のAPI通信、リモートデスクトップ、その他のプロトコルで外と通信したいときはどうするの?
現状のW現環境ではメールとWeb通信以外の通信は内部LANからインターネットへ送ることができない。じゃあ、ファイル転送(FTP)や、独自のAPI通信、リモートデスクトップ、その他のプロトコルで外と通信したいときはどうするの?という疑問が出る。
結論:現状のW社ではメールとWeb通信以外必要ないので許可する必要がない。
ネットワークは原則としてデフォルト・ディナイ(Default Deny)という考え方がある。これは 「原則として、内部のPCからインターネットへの直接通信はすべて禁止(丸ごとシャットダウン)」がスタートライン。
以上より、内部LAN内にあるマルウェアPCは👇となり、C&CサーバのIPアドレスが取得できないので、宛先が設定できない(=C&Cサーバとは通信できない)となる。
・プロキシを使った場合→認証に失敗して通信不可
・内部DNSに再帰的問い合わせをした場合→外部DNSはフルリゾル機能を提供しないので名前解決不可
p.16 Q.uRPFって何?
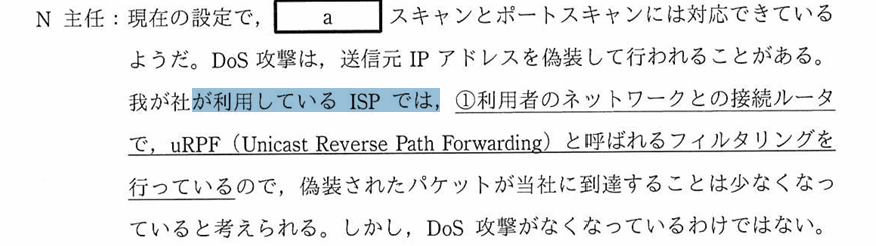
uRPF(unicast Reverse Path Forwarding)とは、ルーティングテーブルと実際の受信パケットを比較して整合性が取れるか否かを確認し、パケットの通過許可/破棄を決める仕組み。
大前提!!
uRPFは外から内に入る通信をフィルタリングするというよりも、「内から外」または「内から内」の通信を安全にしてくれる仕組み。
*勘違いを防ぐために大げさに言ったが、外から内のフィルタリングもできることにはできるのでそれも一応お忘れなく。
内から外への流出を防ぐ!
ネットワークエンジニアやISPの視点から見ると、uRPF(特にルーズモードや接続点での検証)を導入する最大の動機は、外部からの攻撃を防ぐこと以上に、「自社の配下(契約している顧客や利用者)が、送信元IPアドレスを偽装してインターネットへDoS攻撃を仕掛ける『加害者(踏み台)』になるのを防ぐこと」にある。
例:ISPでの導入シナリオ
1.ISP-Aの管理下には多くの企業・顧客が接続している
2.顧客からのパケットは、管理下にあるためIPアドレスの特定が可能
→uRPFによるフィルタリングが可能
3.これにより、管理下の顧客が偽装パケットを送ることを防げる
4.つまり、「ISP-A内で完結する顧客間の通信」+「ISP-Aから外に出るパケット」は偽装パケットである可能性を低くできることになる。
*ただし、ISP-A以外の外部のISPがuRPF等を実施していない場合は、ISP-Aに偽装パケットが届いてしまう。あくまでもuRPFは自分の管理下のパケットの偽装防止にとどまることが多い技術である。
p.16 Q.smurf攻撃って何?
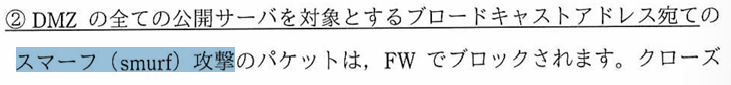
ルータをまたいでDMZ内のすべての公開サーバにパケットがばらまかれた後、何が起きるのか?その「その後」の流れがスマーフ攻撃の恐ろしいところである。
- IPの偽装(スプーフィング):
攻撃者は、あらかじめ送信元IPアドレスを「本当に攻撃したいターゲット(被害者)のIPアドレス」に偽装してパケットを送信する。 - ルータのL2ブロードキャスト変換:
宛先IPがブロードキャストであること(あるいはIPv4のブロードキャストルール)を検知すると、そのセグメントに送り出すときのフレームの宛先MACアドレスを強制的にFF:FF:FF:FF:FF:FF(全員宛て)にしてカプセル化する - 一斉返信(大増幅):
①「なるほど、ネットワーク全体宛ての要求だな(あるいは俺宛てだな)」と認識し、パケットに応じた処理(スマーフ攻撃なら、偽装された送信元IP宛てへのPing応答など)を実行する。
②DMZ内のすべての公開サーバは、ブロードキャストで送られてきたパケットに対して、「送信元(=攻撃された被害者のIP)」宛てに一斉に返信(応答)を送りつける。 - 結果(DDoS状態):
たった1発のパケットを送っただけなのに、DMZにいる数十台・数百台のサーバーが一斉に「被害者」めがけて返信の嵐を浴びせるため、被害者のネットワークやサーバーのリソースがパンク(DoS状態)する。
これが、スマーフ攻撃(およびそれに類するリフレクション攻撃)の仕組み。攻撃者は直接手を下さず、ネットワークの仕組みとサーバーたちを「手下」として使って、爆発的なトラフィックをターゲットに集中させる。
Q.ブロードキャストはL3をまたぐの?
結論から言うと、「通常のブロードキャストはL3をまたがない(ルータを超えない)が、スマーフ攻撃で悪用される『ダイレクトブロードキャスト』という仕組みだけは、例外的にルータをまたいでしまう」というのが正確な事実。
原則、ルータはホスト部をすべて「1」にしたアドレス(例: 192.168.1.255)宛ての通信は跨がせない。しかし、もしルータが「ダイレクトブロードキャスト(L3ブロードキャスト)」の転送を許可する設定になっていると、次のような現象が起きる。
- 攻撃者が、外のネットワークからルータに対して、「あるネットワークのブロードキャストアドレス宛て」のパケットを送りつける。
- ルータはそれを「お、あのネットワーク全体宛ての荷物だな」と勘違いして、ルータをまたいで(ルーティングして)そのネットワークの内部へ送り届けてしまう。
- ネットワークの入り口まで届いたL3ブロードキャストパケットは、最終的にそのセグメント内でL2ブロードキャストに変換され、DMZにいるすべての公開サーバ(全ノード)に一斉にばらまかれる。
これが、「ルータをまたぐのか?」の答え。ルータの設定(ダイレクトブロードキャスト転送)が有効になっていると、ルータをまたいでしまう。
Q.ARPのブロードキャストはどうなっているの?
1. ARPのとき、宛先IPには何が入るのか?
ARP(Address Resolution Protocol)は、「このIPアドレスを使っている人の、実際のハードウェアアドレス(MACアドレス)を教えて!」と周囲に問いかける仕組み。
このとき、ARPのリクエストパケットの中にある宛先IPアドレスには、
- 「今まさにMACアドレスを知りたい、その相手のIPアドレス」がそのまま入る。 (例:「IPアドレス
192.168.1.10の人、あなたのMACアドレスを教えてください」というピンポイントなIPが書かれている)
2. じゃあ、どうやってセグメント全員に届くのか?(ここがミソ)
「宛先IPが特定の誰かのIPを指定しているなら、なんでネットワーク上の全員に届く(ブロードキャストになる)の?」って思うよね。
ここで使われているのが、L2(データリンク層)のMACアドレスのブロードキャスト。
- 宛先IPアドレス(L3): 調べたい相手のIPアドレス(特定の1台のIP)
- 宛先MACアドレス(L2):
FF:FF:FF:FF:FF:FF(ネットワーク機器やセグメントにいる全員宛てのMACアドレス)
つまり、IP層の宛先は「特定のあいつ」を指定しているのに、データリンク層(MACフレーム)の宛先を「全員宛て(FF:FF:FF:FF:FF:FF)」にしてカプセル化して送り出している。
3. 実際に何が起きているのか?
このARPリクエストが流れると、同一セグメント(スイッチの配下)にいるすべての端末がそのデータを受け取る。
- 関係ない端末の反応: 受け取った端末は、「お、MACアドレスのブロードキャストだから中身を見てみよう。……ふむ、宛先IPは
192.168.1.10って書いてあるな。……って、これ俺のIPアドレスじゃないや」と気づき、そのパケットを無視(破棄)する。 - 本当の宛先(該当する端末)の反応: IPアドレスが
192.168.1.10の端末は、「お、これ俺のIPアドレス宛てにMACアドレスを聞かれているぞ!」と気づき、自分のMACアドレスを添えて「私です!私のMACアドレスはこれだよ!」と送信元に向かってお返事(ARPリプライ)を返す。
p.16 Q.UDPフラッド攻撃って何?
UDPはTCPと異なり、コネクションレス型のプロトコルであるため、通信開始時に3ウェイハンドシェイクのような送信元の到達性確認を行わない。そのため、送信元IPアドレスを偽装したUDPパケットを送信しやすく、これを悪用して大量のUDPパケットを送りつけるUDPフラッド攻撃や、第三者のUDPサーバーを利用するリフレクション・増幅攻撃などが行われる。一方、TCPでは3ウェイハンドシェイクによって返信を受け取れることを確認するため、UDPと比較して送信元IPアドレスの偽装を悪用した攻撃が難しい。ただし、TCPでもIPアドレスの偽装自体は可能である。
Q.UDPフラッド攻撃にはどうやって対策するの?
・外からのアクセスを禁止する
・レート制限
・TCPへフォールバック
・CDNの利用
1. 「そもそも外からアクセスさせない」(原則の徹底)
まず大前提として、インターネット全体からアクセスされる必要がないUDPサービス(例えばSNMPやNTP、内部向けのSyslogなど)は、インターネットの境界(ファイアウォール)で外からの通信を完全にシャットアウトさせる
外部からアクセスされて困る管理用プロトコルは、社内ネットワークやVPN経由からしか届かないようにする。これだけで、不要なUDPフラッドやリフレクション攻撃の標的になるリスクを大幅に削ることができる。
2. レートリミット(Rate Limiting / 速度制限)をかける
「サービスは公開したいけれど、異常な量が来たら困る」という場合の定番対策。
・ICMP Unreachableの制限:
サーバやルータがエラーを返す機能自体を完全に殺さなくても、「1秒間に返すICMPエラーは最大ここまで」というレートリミットを設定する。これにより、エラー処理でCPUが100%張り付く(パンクする)のを防げる。
・UDPトラフィックの帯域制限:
特定の送信元や、UDP全体にかけるパケットの流量制限(Rate Limiting)を行い、許容量を超えた分は正当な通信であっても一時的にドロップ(または後回し)する。
3. プロトコル固有の「悪用防止機能」を入れる(DNSの例など)
DNSのように「絶対に外部に公開しなければならないUDPサービス」に対しては、プロトコル側や機器側に対策機能が組み込まれている。
・RRL (Response Rate Limiting):
DNSサーバ側の機能で、同じ宛先から短時間に同じような問い合わせが大量に来た際、すべての応答を返すのではなく、「わざと応答の頻度を落としたり、一部を無視したりする」ことで、DNSアンプ攻撃(リフレクション攻撃)の踏み台として利用されるのを防ぐ。
・TCPへのフォールバック:
攻撃者が怪しい(あるいはパケットが大きすぎる)と判断した場合、DNSサーバがあえて「UDPではなく、TCPで通信し直して(3-way handshakeをして)」と要求することで、送信元IPが偽装されていないかを厳しくチェックできる。
4. 専門の「DDoS防御サービス(スクラビングセンター)」に頼る
DNSサーバーの直近だけで防ぎきれないような、莫大な量のパケットが押し寄せる本格的なボリュメトリック攻撃(帯域枯渇型)の場合、自社のファイアウォールやルータだけで受け止めるのは不可能。
仕組み:
インターネットとの境界の手前に、CloudflareやAWS Shield、各大手通信キャリアが提供する「DDoSスクラビングセンター(洗浄施設)」を挟む。
どう防ぐか:
一度すべてのトラフィックをその洗浄施設に集め、AIや専用ハードウェアで「本物の正当なDNSリクエスト」と「攻撃用の偽装UDPパケット」を瞬時に見分け、怪しいパケットだけを綺麗にゴミ箱に捨てて(スクラブして)、綺麗な通信だけを自社のサーバに届けるという仕組みをとる。
Q.TCPのSeq,ACKはどうなっているの?
前提:
シーケンス番号:自分が相手に送るデータの位置を示す
確認応答番号:相手から受け取ったデータについて、次に受け取りたい位置を示す
フローを見ながら確認していこう!👇
①クライアントが100バイト送信する
クライアント                         サーバー
    │                                  │
    │ DATA                             │
    │ Seq=1001                         │
    │ データ長=100バイト                │
    │ Ack=5001                         │
    │─────────────────────────────────>│
    │                                  │
②サーバがACKを返す
サーバー → クライアント

Seq=5001
Ack=1101

#Ack=1101は「1100番までのデータを受信した。次は1101番から送ってほしい」という意味
#ただし、ACK番号は「受信したバイト数そのもの」ではなく、次に受信したいデータのシーケンス番号を表す。
③クライアントが次のデータを送る
サーバーからAck=1101を受け取ったクライアントは、次のデータを送る。
例えば、今度は50バイト送るとする。
クライアント                         サーバー
    │                                  │
    │ DATA                             │
    │ Seq=1101                         │
    │ データ長=50バイト                 │
    │ Ack=5001                         │
    │─────────────────────────────────>│
    │                                  │

  #相手からのACKがそのまま自分のSeqになる。
p.20 Q.ソーシャルエンジニアリング→漏洩→マルウェア侵入の順番について
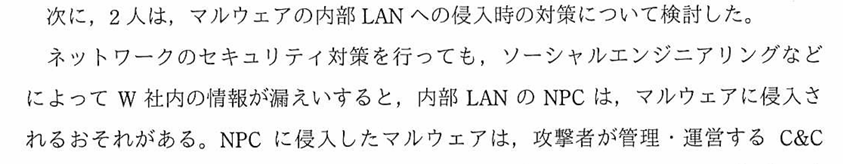
なんか、感覚的にはマルウェアが不正侵入→情報漏洩という感じがするが、記載にはソーシャルエンジニアリング→漏洩→マルウェア侵入と書かれていていまいちピンとこない。それを明らかにしていこう!
「情報漏えい ➔ マルウェア侵入」の実際のシナリオ
- ソーシャルエンジニアリングで「情報が漏えいする」
- 攻撃者は、巧妙なフィッシングメールや偽のログイン画面などを使って、社内の従業員をダマし、社内システムのID・パスワードや機密情報(社内情報の漏えい)をペロッと入力させる。
- 盗んだ「合鍵」で侵入する
- 攻撃者は、手に入れたその「本物のID・パスワード」を使い、VPNやリモートアクセス経由で「正規の社員になりすまして」社内ネットワークへ正面からログインする。
- 中に入ってから「マルウェアに侵入(設置)する)」
- 外部からの直接攻撃はファイアウォールやセキュリティ製品でガードされていても、「内部の人間になりすましたログイン」であれば門番は通してしまう。無事に内部に入り込んだ攻撃者が、その足がかりを使って内部のPC(NPC)にリモートでマルウェアを送り込み、感染・侵入させる。
一般的なイメージ(直接実行型)
→「メールで送られてきた怪しいファイルをユーザーがうっかりダブルクリックして、その場で直接マルウェアに感染するパターン」
今回の問題のイメージ(なりすまし・侵入型)
→ソーシャルエンジニアリングでまず情報(パスワード等)が外部に漏えいし、それを悪用されて不正ログインされた結果、あとから内部のPCにマルウェアを持ち込まれて侵入されるパターン。
つまり、この文章の「情報が漏えいすると」という部分は、ウイルスファイルを踏むことではなく、「攻撃者に社内システムの合鍵(ID・パスワードなど)が渡ってしまうこと」を指している。この視点の違いが分かれば、この順番の意図がスッキリ繋がるはず!
p.22 Q.ゾーンレコードの見方
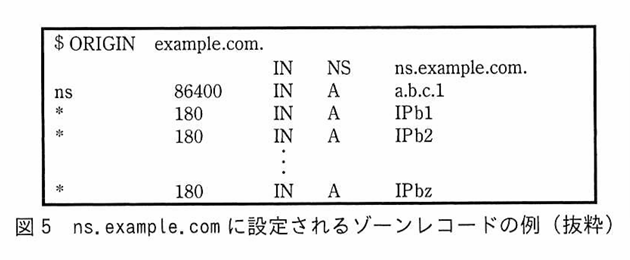
1行目・2行目(NSの定義)
$ORIGIN example.com.IN NS ns.example.com.-
example.comの権威DNS(コンテンツサーバー)がns.example.comであることを示している。 - 「このゾーンのネームサーバーである
ns.example.comのIPアドレスはa.b.c.1ですよ」という、サーバー自身の住所登録。自分がどこにいるかを自分で自分に教えている状態(グルーレコード的な役割)。
3行目(NSのIP定義)
ns 86400 IN A a.b.c.1- ネームサーバー自身のグローバルIPアドレスが
a.b.c.1であることを定義している。
4行目以降(* が並ぶ部分)
* 180 IN A IPb1* 180 IN A IPb2…* 180 IN A IPbz- これらはNS(DNSサーバー)のIPではない! 世界中にいる「ボット(感染PC)のIPアドレス群」。
こここそが、「Domain Flux」と「Fast Flux」の正体。
*(アスタリスク) = Domain Flux の正体- これはDNSの「ワイルドカード」機能です。「
abc123xyz.example.com」だろうが「random999.example.com」だろうが、マルウェアがどんなに適当なホスト名(サブドメイン)を勝手に生み出してアクセスしてきても、すべてこの設定に強制ヒット(マッチ)させるための魔法の記号。
- これはDNSの「ワイルドカード」機能です。「
IPb1,IPb2… = Fast Flux の正体- ワイルドカードで受け止めたあとに返すAレコードのIPアドレスとして、攻撃者が用意した無数のボット(感染した一般PC)のIPアドレスが複数(ラウンドロビン等で)登録されている。
180(TTL)の意味- 単位は秒(3分)。キャッシュをあえて極端に短く(180秒で)切れさせることで、問い合わせが来るたびに返すボットのIPをコロコロ切り替え、追跡やブロックをかわす仕組みになっている。
p.22 Q.プロキシ認証&Windows統合認証(Kerberos)の全フロー
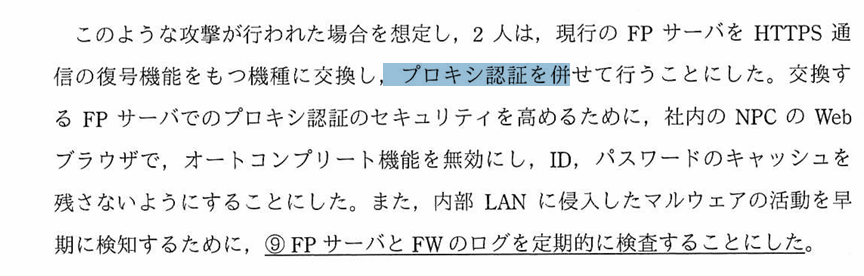
プロキシ認証は、読んで字のごとく「プロキシを利用する際に正当なユーザ化を認証する」ことを意味している。では、実際のフローを確認していこう!
ステップ①:初回アクセスとプロキシからの要求(407)
- ルーティング判断: クライアントPCはPACファイルや例外リストを見て、「この通信はプロキシ経由だな」と判断し、宛先のホスト名(FQDN)をHTTPリクエストのHostヘッダー等に含めてプロキシ(FPサーバ)に送信する。
- 未認証の検知: プロキシはリクエストの
Authorizationヘッダーを確認するが、まだ何も入っていない(空)。 - 407応答: プロキシは「身分証がないので通せません」として、
407 Proxy Authentication Requiredを返す。このとき、応答ヘッダー(Proxy-Authenticate)で「うちでは Negotiate(Kerberos / NTLM) が使えますよ」とクライアントに伝える。
ステップ②:ブラウザとOS(Windows)によるKerberosチケットの取得
- 認証方式の選択: 407を受けたブラウザは、画面にポップアップを出さず、裏側でOS(Windows)のセキュリティ機構(SSPIというAPI)を呼び出し、「プロキシ用の認証チケットをくれ!」と依頼する(=Windows統合認証:ブラウザとOSのやり取りとりを担う)。
- TGSへのチケット要求(STの取得):
- Windows OSは、すでに社内ドメインログオン時に持っている TGT(Ticket Granting Service用チケット) を取り出す。
- OSは、KDC(Key Distribution Center)内の TGS に対して、「このプロキシサーバー(SPN:Service Principal Name というプロキシの識別名)にアクセスしたいので、サービスチケット(ST)をください」と要求する。
- このとき、自分の身元証明として TGT と、現在のセッションキーで暗号化された オーセンティケーター(タイムスタンプ等を含む)を一緒に送る。
- TGSによる検証とSTの発行:
- TGSはTGTを復号して正当性を確認し、さらに送られてきたオーセンティケーターをセッションキーで復号してタイムスタンプ等の整合性をチェックする。
- 問題なければ、プロキシとの間で使う「新しいセッションキー」を含めた サービスチケット(ST) を発行し、クライアント(OS)に返す。
- ブラウザへの引き渡し: OSは受け取ったSTと新しいセッションキーをブラウザに渡す。
ステップ③:プロキシへの認証情報の提示
- 認証ヘッダーの付与:
- ブラウザは、受け取った ST と、新セッションキーで暗号化された自分のオーセンティケーターをセットにして、SPNEGO(Negotiate)トークンとして組み立てる。
- それを
Authorization: Negotiate [トークン]というヘッダーに詰めて、もう一度プロキシにリクエストを投げる。
ステップ④:プロキシによる検証と通信の許可
- プロキシによる復号と検証:
- プロキシ(サービス側)は、Active Directoryと事前に共有している自分の秘密鍵(キータブ)を使って、送られてきた ST を復号し、中身が本物か・有効期限内かを確認する。
- 次に、STに含まれていたセッションキーを使って、クライアントの オーセンティケーター を復号し、タイムスタンプやユーザー名を確認する。
- 通信の確立:
- 「間違いなく社内の正規ユーザーのPCだな」とプロキシが確信したら、ここで初めて認証が完了(OK)となる。
- 以降の通信は、プロキシが仲介してインターネット(またはボット)へのアクセスを代理実行する。