- 設問1
- 設問2
- 設問3
- 設問5
- (1)APのFQDNとIPアドレスをPCのhostsファイルに記載する
- (2)APサーバに対するPCからのアクセスがなくなっていることを確認する
- p.13 PCのホスト名を管理する意味は?
- Q.動的なIPアドレスをどうやってDNSで管理しているのか?
- p.14 Q.プロキシはどうやって戻りパケットをクライアントに割り振っているの?
- p.14 Q.独自のプロトコルを利用ってどうゆうこと?
- p.15 Q.仮想サーバでVRRPv3を動作させるってなに?
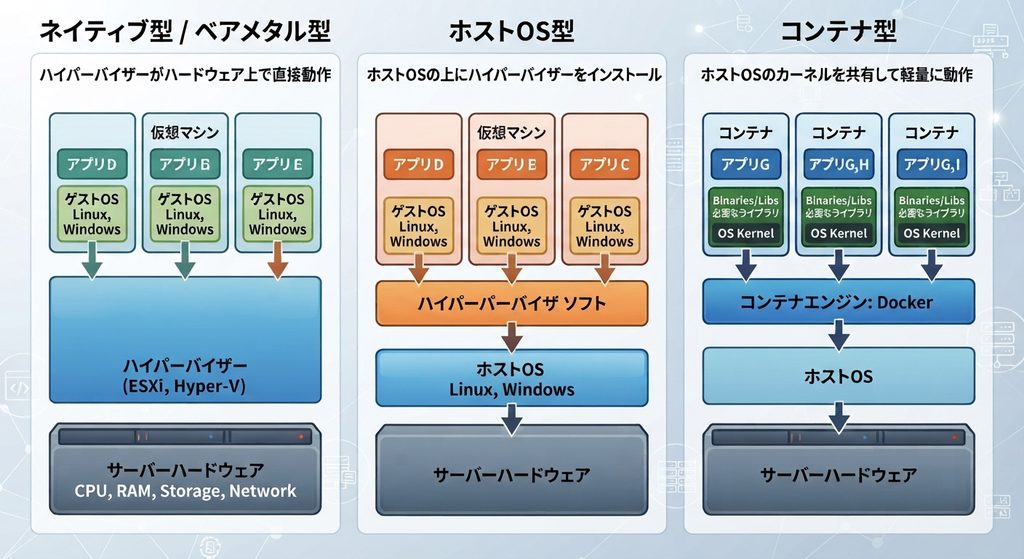
- p.15 コンテナ仮想化技術の概要(イラスト/ハイパーバイザーの違い等..)
- p.16 Q.コンテナ仮想化の時に共用リバースプロキシを置く理由は?
- Q.コンテナ仮想化で共用リバースプロキシを使わないとどうなる?
- Q.なんでコンテナサーバには仮想スイッチと仮想ブリッジがあるの?
- Q.仮想スイッチと仮想ブリッジの違いは?
- Q.仮想ルータのポートフォワードは何をしているの?
- p.19 Q.専用APになった途端、懸念事項が増える理由は?
- Q.コンテナ仮想化技術が適さないとはどういうこと?
- Q.ハイパーバイザー型とコンテナの使い分けの基準は?
設問1
(1)ア:ハイパーバイザー イ:VRID ウ:255
ア:ハイパーバイザー
物理的なハードウェア(CPU、メモリ、ハードディスクなど)の上に、複数の「仮想マシン」を同時に動かすための専用ソフトウェア(管理者・司令塔)のこと。これがないと、1台の物理サーバーの上で「WindowsとLinuxを同時に動かす」といったことができない。
イ:VRID
VRIDとはVRRPの識別子のこと。1~255の値をとる。
28-1個の1~255の値をとることができる。(28は256だが、0は使われないため1~255となる)
ウ:255
上述したようにVRIDは28-1個(0は除く)なので255となる
(3)バックアップがVRRPアドバタイズメントを決められた時間内に受信しなくなる
マスターは定期的にVRRPアドバタイズメントをマルチキャスト(224.0.0.18)で送信する。それを時間内に受け取らないと、障害と判断してバックアップはマスターの仮想IP/MACを引き継ぐ。
設問2
(1)外部ではコンテナサーバに付与したIPアドレスが利用されることはないから
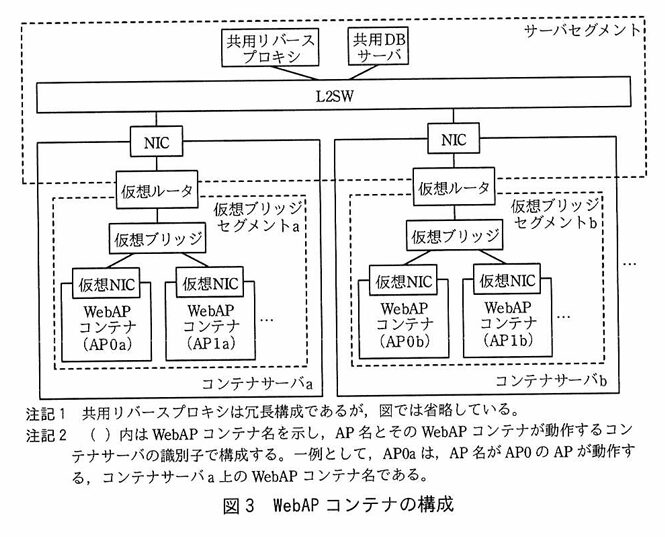
この問題では、コンテナサーバ内の仮想ブリッジセグメントがほかのコンテナの仮想ブリッジセグメントと同じIPアドレスを使ってもよい理由が問われている。
A.仮想ブリッジ間で同じIPをつかってもよい理由は👇である。
外部から見えないから:
コンテナ内のプライベートIPはあくまでサーバー内の閉じた空間だけで使われるものであり、外部のネットワーク(サーバーセグメント)でそのIPがそのままルーティングされたり利用されたりすることはないため。
仮想ルータが隠蔽してくれるから:
外部との通信はすべてコンテナサーバー内の「仮想ルータ」がNAPT(ポートフォワード)で中継・変換するため、外から見れば各コンテナサーバーの代表IP(およびポート)しか見えていない。そのため、異なるコンテナサーバーの間で内部のプライベートIPが重複していても、お互いに干渉せず共存できる。
つまり、「外部からコンテナサーバ内に付与したIPアドレスが利用されることはないから」という回答になる。
(2)ホストヘッダーフィールド
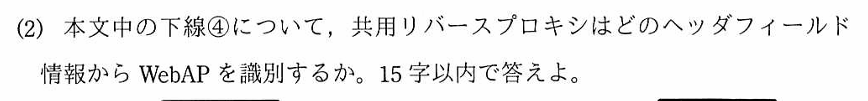
現在の構成ではすべての宛先IPアドレスが共用リバースプロキシ宛てになり、そこで終端する。では、その後はどうやってコンテナに届けるの?
A.ホストヘッダーフィールドを見る。HTTPのホストヘッダーフィールドにはFQDN(ホスト名とドメインを合わせた修飾子)が格納されているため、そのFQDNへパケットを振り分ければIPに依存しない振り分けが可能になる。
共用リバースプロキシでの終端と識別:
外部からの通信の宛先IPアドレスがすべて同じプロキシ(例: 192.168.0.98)であっても、プロキシがパケットの中身(HTTPのHostヘッダー)を読み取ることで、「これはAP0宛てだな」「こっちはAP1宛てだな」と正確に識別できる。
適切な振り分け:
識別した結果をもとに、あらかじめ決められたルール(表4など)に従って、裏側にある適切なコンテナサーバーやポートへリクエストを振り分けることが可能になる。
(4)宛先IP:172.16.0.16 宛先ポート:80
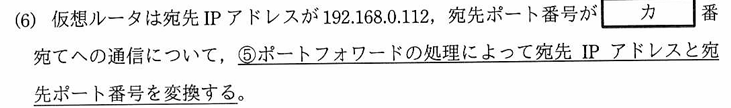
この問題は図と照らし合わせながら進めていくと答えが見えてくる。
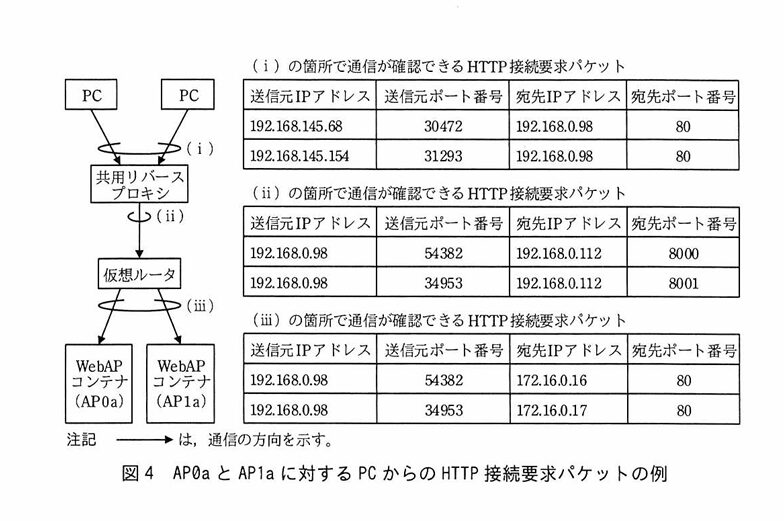
仮想ルータのプロセスを見ると(iii)が該当している。それを見ると、宛先IPが172.16.0.16、宛先ポートが80番であることが分かる。
設問3
(1)①NAPT機能 ②ポートフォワード機能
独自プロトコルの場合、L3・L4の書き換えがアプリケーションに影響を及ぼすパターンもある。そのため、途中でIPやポートを書き換えるNAPT機能やポートフォワード機能を挟んでも、アプリの通信が壊れずにちゃんと動くかをAPごとにテスト・確認しなければならない
(2)複数のIPアドレスを設定し、IPアドレスごとに専用APを識別する仕組み
この問題では、専用APが同一のポート番号で運用されている場合に、どうやって振り分ければいいの?ということが聞かれている。では、1つずつ進んでいこう!
Q.なんで「ポート番号が同じ」だと困るの?
- 通常のWebAP(HTTP)であれば、たとえ同じIP・同じポート(80番など)であっても、HTTPリクエストの中身にある「Hostヘッダーフィールド(FQDN)」をプロキシが読み取って、「こっちはAP0、あっちはAP1」とスマートに振り分けることができる。
- しかし、専用APは独自のプロトコルを使っているため、HTTPのHostヘッダーのような便利な目印が使えない(またはプロキシが中身を解釈できない)場合がある。
- その結果、「どちらの専用APも同じポート(例えば
TCP 5000番など)で待ち受けています」となったとき、「ポート番号が一緒だから、ルータやロードバランサーがどちらに振り分ければいいか判断できない!」という問題が起きる。
2. どうやって解決するの?(今回の解答)
ポート番号が被ってしまって区別できないのであれば、「入り口のIPアドレスを専用APごとに別々にする」というアプローチを取る。
- 仕組みのイメージ:
- 専用AP(その1)用のアドレス:
192.168.0.101(ポートは共通の5000番) - 専用AP(その2)用のアドレス:
192.168.0.102(ポートは共通の5000番)
- 専用AP(その1)用のアドレス:
- こうしておけば、たとえ宛先のポート番号がどちらも「5000番」で同じだったとしても、「宛先のIPアドレス」が
101なら専用AP(その1)、102なら専用AP(その2)と、ルータやロードバランサーがIPアドレスを基準にして完璧に識別・振り分け(ロードバランス)できるようになる。
ここまででおそらくこう思うだろう。。ん?当たり前じゃん!問題に出すようなことか?問題にだすんだからもっと画期的な頭を使った回答だと思ったら超当たり前のことじゃん。。。
恐らく拍子抜けしたことでしょう。でも、ネットワークスペシャリストの問題ではたまにこういう拍子抜けする問題も出てくるので、答えが浮かばなかったら超無理やりでも強引だと思うような答えを書くと意外とそれが正解だったりする。
設問5
(1)APのFQDNとIPアドレスをPCのhostsファイルに記載する
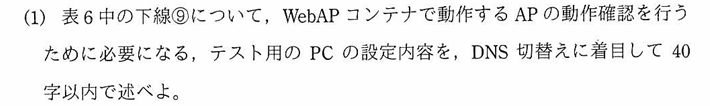
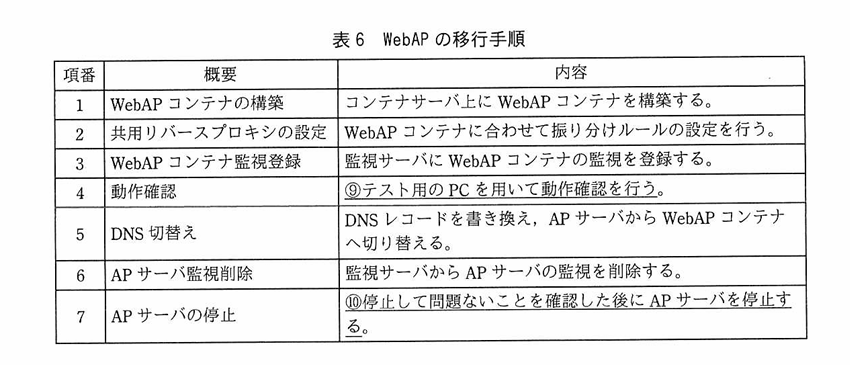
これは、テスト用PCからコンテナ内のAPへのテストするフェーズをあらわしている。
注目したいのは、項番5のDNS切り替えよりも前の段階でテストをしているということ。つまり、今までと同じ手順でアクセスしようとしてもDNSが切り替わっていないので、一生、コンテナ内のAPにたどり着くことができない。。。ではどうするのか?
A.「APのFQDNとIPアドレスをPCのhostsファイルに記載する」。DNSは切り替えられていない場合でも、「もう、ローカルで強制的にアクセスできるようにしちゃおうよ!」というのがhostsファイルである。
基本的なDNS問い合わせの流れは
1.hostsファイル
2.スタブリゾルバのキャッシュ
3.フルサービスリゾルバのキャッシュ
4.権威DNS
となっている。ここのhostsファイルをスタティックに設定することでDNSサーバに反映されていないFQDNにもアクセスが可能になる。
(2)APサーバに対するPCからのアクセスがなくなっていることを確認する
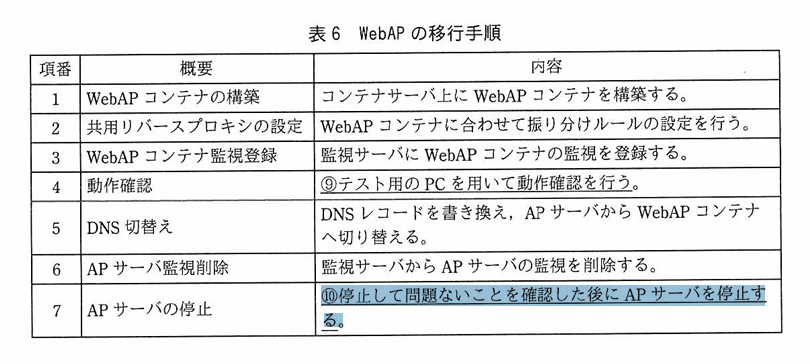
APサーバと通信中であるにもかかわらず、停止するとユーザエクスペリエンス(UX)が悪くなる。なぜなら途中で通信が切れたり、セッションが中断されて再度ログインしなくてはならなかったりとUX面でのデメリットが起きる。
なので、「APサーバに対するPCからのアクセスがなくなっていることを確認する」ことが大切。
p.13 PCのホスト名を管理する意味は?
社内ネットワークでは、システム管理者や監視サーバーが社用PCに対してリモートデスクトップ接続をしたり、ソフトウェアの配布・遠隔サポート(メンテナンス)を行ったり、セキュリティインシデント発生時に特定のPCを特定・隔離したりする必要がある。その際、「IPアドレス」だけでなく「ホスト名」でPCを識別・名前解決できると非常に都合が良いため、コンテンツDNSサーバで管理されている。
Q.動的なIPアドレスをどうやってDNSで管理しているのか?
PCなどはDHCPを使って動的にIPアドレスが割り当てられていることが多い。では、その動的なIPアドレスをDNSに反映するにはどうしたらいいの?
A.DDNS(Dynamic DNS)という仕組みを使っている。
PCがネットワークに接続してDHCPサーバーからIPアドレスを取得した際、そのDHCPサーバー(あるいはPC自身)が自動的にDNSサーバーへ連絡し、「今のこのPCのIPアドレスは〇〇です」とDNSレコードをリアルタイムに登録・更新できる。
これにより、IPアドレスが動的に変わっても、DNSを見れば常に最新のIPアドレスが引けるようになっている。
p.14 Q.プロキシはどうやって戻りパケットをクライアントに割り振っているの?
結論から言うと、プロキシはセッション管理によって通信の対応を管理している。
簡単な挙動はこんな感じ👇
1.社内PC Aがプロキシにアクセスするとき、プロキシ側で「PC A専用の受信用ポート(あるいはセッション)」が割り当てられる。
2.プロキシがインターネット側へリクエストを出す際、プロキシ自身のIPアドレスと「特定の送信元ポート番号」を使って外へ通信する。
3.インターネット上のサーバーから応答が帰ってくるとき、そのパケットの「宛先ポート番号」には、プロキシが外へ出すときに使ったそのポート番号が入ってくる。
4.プロキシは「このポート番号宛てに来た応答だから、最初にPC Aから受けた通信の返答だな」と判断し、PC Aへそのまま返す。
p.14 Q.独自のプロトコルを利用ってどうゆうこと?
独自のプロトコルとは、文字通りHTTPなどの一般化されたプロトコルではないということ。つまり、既存のプロキシを使うと、解釈できない可能性があることをここで暗に示している。
p.15 Q.仮想サーバでVRRPv3を動作させるってなに?

VRRPってルータ(ファーストホップ)を冗長化するものじゃなかったっけ? なんでサーバーで動かしてるの?
A.結論から言うと、「ルータではなく、サーバーのIPアドレス(仮想IP)を2台で共有し、障害時に自動で切り替えるための“仕組み”としてVRRPをそのまま流用している」から。
p.15 コンテナ仮想化技術の概要(イラスト/ハイパーバイザーの違い等..)
| VM | コンテナ | |
|---|---|---|
| 仮想化対象 | ハードウェア/マシン環境 | OS上のプロセス環境 |
| ゲストOS | 必要 | 基本不要 |
| カーネル | VMごとに持つ | ホストと共有 |
| 起動 | 比較的遅い | 速い |
| リソース | 比較的大きい | 軽量 |
| 異なるOSカーネル | 可能 | 基本不可 |
| 主な用途 | OS単位の分離 | アプリ単位の分離 |
p.16 Q.コンテナ仮想化の時に共用リバースプロキシを置く理由は?
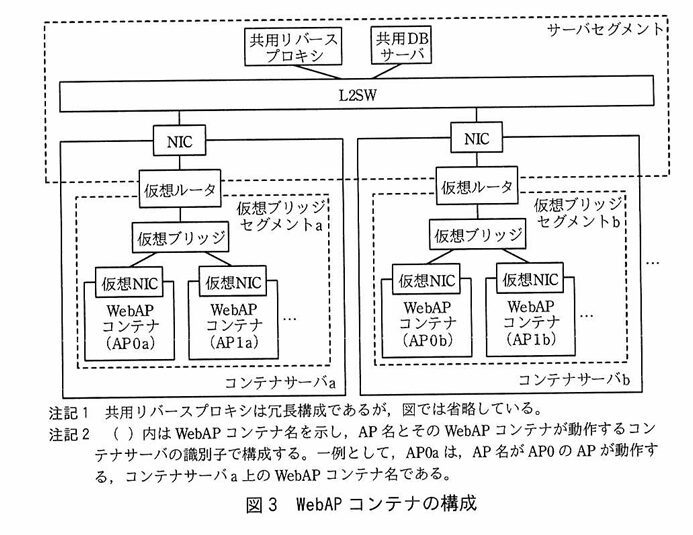
ハイパーバイザー型の時は共用リバースプロキシを導入していない。でも、コンテナ仮想化になったら急に、何の説明もなく共用リバースプロキシが追加されている。なぜ?
A.仮想マシンはそれぞれが独立した「本物のPC」に近い状態なので、NICや仮想SWをとおして、1台ずつに直接IPアドレスを割り当てて外から直接アクセスさせやすい構造になっている。
一方、コンテナサーバーの中にある個々の「WebAPコンテナ」は、基本的に内部用のプライベートなIPアドレスで動いている。そのため、インターネットや外部のPCから、直接中のコンテナのIPアドレスを指定して通信することができない。だからこそ、外からの窓口となる「共有リバースプロキシ」を外側にドンと構え、外部からのアクセスを一旦すべてそこで受け止めて、中のコンテナたちへ適切に中継・振り分け(ロードバランス)をする必要がある。
Q.コンテナ仮想化で共用リバースプロキシを使わないとどうなる?
1. IPアドレスがすぐ枯渇する & ルーティングが破綻する
- 仮想マシンは数台〜数十台程度しか作らないことが多い。コンテナは「軽くて大量に作れる」のが最大の武器。
- もしコンテナ1つひとつに、サーバーセグメントのまともなIPアドレスを直接割り当てていたら、アプリをスケール(増産)させるたびに大量のIPアドレスを消費し、ネットワークのIP枯渇を招く。また、ルータが管理する経路情報(ルーティングテーブル)の数も爆発してしまう。
2. コンテナの最大の強みである「動的な増減(スケーリング)」ができなくなる
- システムにアクセスが殺到したとき、コンテナ環境では「じゃあ今すぐAP0のコンテナを2個から5個に増やそう!」ということが瞬時に行われる。
- もしコンテナに直接IPが固定されていたら、増やすたびにDNSの書き換えやクライアント側の設定変更が必要になり、自動でのスケールアウトが非常に難しくなる。
- 共有リバースプロキシがあれば: 裏側でコンテナが何個増えようが減ろうが、クライアントは常にプロキシ(のIP)だけを見ていればいいので、窓口を一本化できる。
→VRRPやれば窓口一本化できるじゃん?
A.VRRPアドバタイズメントパケットが大量に発生して帯域を圧迫する。本来VRRPとは数台程度で運用するものだが、コンテナは数百台動作させることがざらにあるためVRRPは不向き。
3. ポート番号の競合(かぶり)を防ぐ
- コンテナの中では、それぞれのアプリケーションが「80番ポート」や「8080番ポート」など、決まったポートを使って動きたがる。
- もしプライベートIPとNAPT(ポートフォワード)の仕組みを使わず、直接外のネットワークにさらそうとすると、同じポートを使うコンテナ同士がバッティングして起動できなくなる。
- 内部はプライベートIP(例:
172.16.0.16等)で閉じ込め、コンテナサーバーの仮想ルータ(NAPT)でポート番号をうまく変換(例: 8000番、8001番に変換)してあげるからこそ、同じポートを使うコンテナを安全に同居させることがでる。
Q.なんでコンテナサーバには仮想スイッチと仮想ブリッジがあるの?
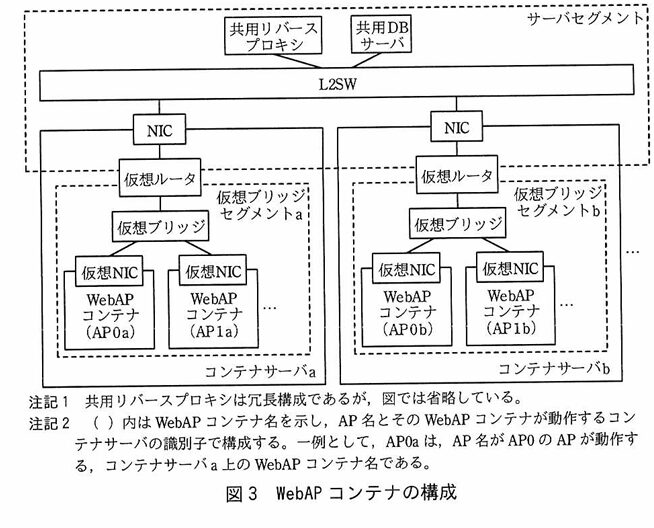
Q.ハイパーバイザー型の時はホストサーバ内には仮想スイッチしかなかった。しかし、コンテナサーバの場合、仮想ルートと仮想ブリッジが内部にある。これらの違いはなぜ起きるの?
A.コンテナサーバーの中身が、外部から切り離された「完全に独立したプライベートなネットワーク空間(L3空間)」になっているから。ハイパーバイザー型の際は、DNSに直接、仮想サーバのIPを指定できた。しかし、コンテナの場合はコンテナ内の閉じた空間でIP振り分けが行われている。そのため、外と内の異なるネットワークをつなぐために、仮想ルータが必要になる。
Q.仮想スイッチと仮想ブリッジの違いは?
ハイパーバイザー型の時は仮想スイッチが使われ、コンテナ仮想化の時は仮想ブリッジが使われている。これらの違いは何なのか?
A.基本的な動作は両者ともL2スイッチの挙動をする
仮想スイッチ(Virtual Switch):
主にハイパーバイザー型の仮想マシン環境(VMwareやHyper-Vなど)でよく使われる名称。「物理的なL2スイッチをソフトウェアでそのまま再現している」というニュアンスが強いため、スイッチと呼ばれる
仮想ブリッジ(Virtual Bridge):
主にLinuxのカーネル機能やコンテナ環境(Dockerなど)でよく使われる名称。Linuxの伝統的なネットワーク機能である「ブリッジング(複数のインターフェースを橋渡しする機能)」をそのまま利用しているため、古くから「ブリッジ」と呼ばれている。
Q.仮想ルータのポートフォワードは何をしているの?
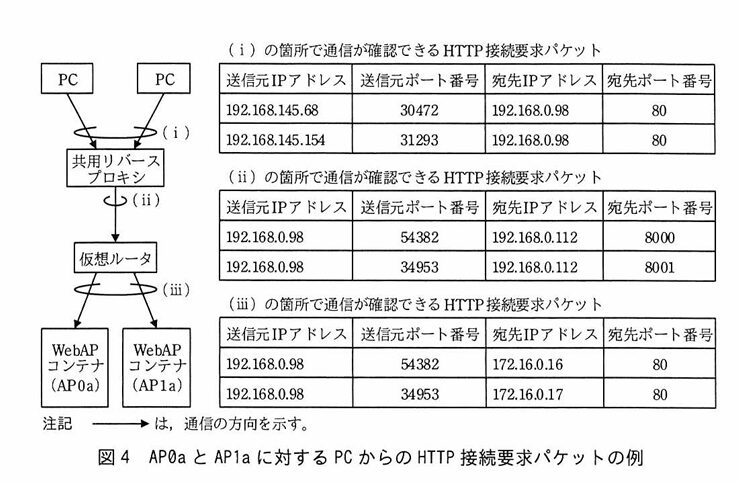
仮想ルータがポートフォワードでWebAPコンテナに振り分けた後、それの応答が仮想ルータに届いたら共用リバースプロキシに渡すよね?これさ、複数のパケットが共用リバースプロキシから届いたら、WebAPコンテナからの応答が、共用リバースプロキシのどのセッションだっけ?ってごちゃごちゃにならないの?
A.結論から言うと、共有リバースプロキシが、コンテナサーバーへリクエストを送る際に「送信元ポート(エフェメラルポート)」を毎回ランダムに(バラバラに)変えて送信しているため、絶対に混ざったりぐちゃぐちゃになったりしない。
p.19 Q.専用APになった途端、懸念事項が増える理由は?
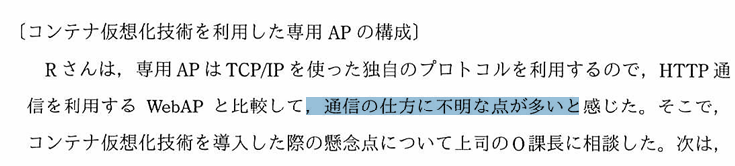
Q.専用APを使うとなった途端、懸念点が出てきたりとか対処すべきことがでてきた。。。なんで?なんで専用APになった途端にそんな環境がガラッと変化したみたいなニュアンスを出すの?具体的にどういうこと?
A.HTTP通信(WebAP)から「独自のプロトコル(専用AP)」に変わると途端に考慮事項が増える理由は、一言で言うと「世の中の便利なネットワーク機器やプロキシが、その独自ルールを理解してくれないから」である。具体的に何が面倒になるのか、大きく2つの理由に分けて解説する。
1. ロードバランサー(振り分け)の限界(O課長の指摘)
- HTTPの場合:
HTTPは標準化されているため、リバースプロキシ(NginxやHAProxyなど)がパケットの中身(HostヘッダーやURL)を簡単に読み取り、「このリクエストはAP0へ、こっちはAP1へ」とスマートに振り分けられる。 - 独自プロトコルの場合:
独自の通信規約(バイナリ形式など)を使っている場合、一般的なHTTPプロキシはその中身を理解できない。 さらに、もし複数の専用APが「同じポート番号」を使って待ち受けている場合、従来のL4(TCP/IP)の仕組みや単なるIP/ポートの転送だけでは、「どの専用AP宛ての通信なのか」を外側から識別して綺麗にロードバランスするのが非常に難しくなる。そのため、その独自プロトコルを解釈できる専用の負荷分散製品が必要になる。
2. 仮想ルーター(NAPT)との相性問題(Rさんの懸念)
- HTTPの場合:
HTTPは、途中でIPアドレスやポート番号がNAPT(ポートフォワード)で書き換えられても、アプリケーション層(ブラウザとサーバー)の動作には基本的に影響しない。 - 独自プロトコルの場合:
アプリケーションの仕様によっては、パケットの中身(データ本体)のなかに「自分自身のIPアドレスやポート番号」を書き込んで通信相手に伝えているような古い・特殊な設計のプロトコルが存在する。 もしそんな通信を途中の仮想ルーターでNAPT変換してしまうと、パケットのヘッダー情報と、中身のデータに書かれているIP/ポートが矛盾を起こし、通信が途中でプツッと切れてしまうという現象が起きる。そのため、「仮想ルーターのNAT機能を挟んでも本当に動くのか?」という実機テストや検証が必要になる。
Q.コンテナ仮想化技術が適さないとはどういうこと?
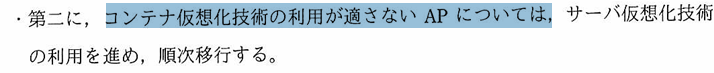
結論から言うと、「コンテナだから専用APが絶対に動かない」わけではありない。最大の分かれ目は、「ネットワークの仕組み(IPやポートの変換・共有)をどれだけ強制されるか」という点にある。
1. なぜ「コンテナ」だと専用APの運用が難しくなるのか?(ハードル)
前にお話しした通り、コンテナ環境というのはひとつのOS(カーネル)やホストを複数で共有するエコシステム。そのため、以下の制約が強くかかる。
- ホストのIPと仮想ルータ(NAPT/ポートフォワード)の壁:
コンテナ環境では、外部からの通信は「コンテナサーバーの物理IP + ポートフォワード(DNAT)」がほぼ必須。必ず経由して内部のコンテナへ届けられる。 すでに見た通り、アプリの内部(プログラム)が自分のIPやポート番号に依存している特殊な独自プロトコル(専用AP)の場合、このルータによる勝手なアドレス・ポート変換(NAPT)のせいで、アプリの動作やセッションが壊れてしまうリスクが高い。 - ポートの競合問題:
複数の専用APが「同じポート番号」を使って待ち受けている場合、コンテナ側で綺麗にさばくためには、先ほど問題にあがった「入り口のIPアドレスを分ける仕組み(複数のIP設定)」や、それを識別できる高度な専用ロードバランサーをわざわざ用意・構築しなければならない。
つまり、「コンテナ化しようとすると、ネットワークの変換(NAPT)や特殊なIP割り当てのせいで、アプリ側に大改修が必要になったり、インフラの設計がめちゃくちゃ面倒になる」ため、「コンテナ化のメリット(軽量・迅速な起動・リソース効率)よりも、手間やリスクが勝ってしまう=適さない」となる。
2. なぜ「サーバー仮想化(VM)」なら専用APをそのまま動かせるのか?
一方で、従来のサーバー仮想化技術(VM:仮想マシン環境)はどうだろう?
- VMは「1台の独立したコンピュータ」として振る舞える:
VM(仮想サーバー)は、コンテナと違って自分専用の仮想OS(ゲストOS)を丸ごと持っている。 - 物理サーバーと同じ感覚でネットワークを直結できる:
VMのネットワーク(仮想NIC)は、ホストの複雑なNAPTやポートフォワードを無理に経由させなくても、L2スイッチングのレベルで「独自のIPアドレス」や「専用のポート」をそのまま外部にダイレクトに露出させることができる。 - アプリの改修が不要:
これまでの「物理サーバー上で動いていた専用APの環境」を、そのままそっくりVMの中に移植すればよいため、IPやポートが勝手に書き換えられるストレスや、コンテナ特有のネットワーク制約を受けずに済む。
Q.ハイパーバイザー型とコンテナの使い分けの基準は?
ハイパーバイザー型には台数がすくないため直接、外部とつながるIPを振り分けられる。一方、コンテナは台数が多いので内部セグメント用のIPが割り当てられる。その結果、コンテナはNAPTとポートフォワードを要求する。
ここで一つの疑問。。では、ハイパーバイザー型とコンテナはどういう状況だったらどっちを使った方がいいとかっていう基準とかは合ったりするの?そこらへんがよくわからない。
1. サーバー仮想化(VM)を選ぶべきケース(向いているシステム)
コンテナでは都合が悪く、VM(ハイパーバイザー)を選ぶべきなのは次のようなケース。
- レガシーアプリケーションや独自の専用AP:
今回の試験問題に出てきたような、独自のプロトコルを使っていたり、アプリ内部が「自分のIPアドレスやポート番号」にガッツリ依存しているもの。コンテナ特有のNAPTやポート変換を挟むと壊れてしまうため、VMで独立したOS環境を与えてあげる必要がある。 - 異なるOS環境を混在させたい場合:
例えば、Linuxのコンテナサーバー上で、どうしてもWindows Server専用のアプリケーションを動かしたい場合など(コンテナはホストのOSカーネルを共有するため、異なるOSの混在ができない)。 - 強固なセキュリティ・完全な隔離が必要な場合:
コンテナはカーネルを共有しているため、理論上は仮想マシン(VM)のハイパーバイザーによる完全なハードウェアレベルの隔離よりもセキュリティの境界が弱くなる。厳格なマルチテナント分離が必要な場合はVMが選ばれる。
2. コンテナを選ぶべきケース(向いているシステム)
コンテナが選ばれるのは、単に「軽いから」ではなく、システムの性質がクラウドネイティブに向いている場合。
- マイクロサービス構造のWebアプリ:
機能を細かく分割し、アクセス増減に合わせてコンテナを何十・何百個と自動で高速にスケールアウト(増減)させたい場合。 - 標準的なプロトコル(HTTP/HTTPS等)を使うサービス:
プロキシやリバースプロキシ、ロードバランサーが標準で中身を解釈して綺麗に振り分けられる仕組みの上で動くもの。 - 短時間でデプロイ・起動を繰り返したい場合:
数秒で起動・停止ができるため、CI/CD(継続的インテグレーション・デリバリー)や開発環境の統一に非常に強い。