- 設問1
- 設問2
- 設問3
- 設問4
- 設問6
- (1)source MAC:現行のディレクトリサーバ destination MAC:新ディレクトリサーバ
- (2)source MAC:現行のL3SW1 destination MAC:スタックL3SW
- (3)172.16.254.128 ~ 172.16.254.254
- (4)現行のFWと新FWの仮想IPアドレスが重複する
- (7)172.17.11.1
- (8)PCが収容されているサブネットを識別し、対応するDHCPのスコープからIPアドレスを割り当てるため
- p.2 Q.現行のVLAN設定方法は?
- Q.再帰問い合わせとフォワーダの違いは?
- p.3 Q.NICチーミングってなに?
- p.3 Q.VRRPアドバタイズメントはどこを流れるの?
- p.3 Q.STPってなに?
- Q.RSTPって何?
- Q.プロポーザルとアグリーメントって何?
- Q.RSTPのポート選出フロー
- Q.RSTPで障害が起きたら?
- p.7 アクティブ/アクティブのチーミングって何?
- Q.スタックのIPアドレス振り分けはどうなっているの?
設問1
(1)a:フォワーダ b:プライオリティ値
a:フォワーダ
DNSサーバーが名前解決の依頼を受けたとき、自分自身がそのゾーンの権威サーバー(オリジナルデータを持っているサーバー)ではない、かつキャッシュにも持ってない場合、「自分でインターネット上の他の権威サーバーに問い合わせに行く(反復問い合わせを行う)のではなく、あらかじめ指定した別のDNSサーバー(ISPのDNSなど)に丸投げ(転送)する機能」のことをDNSフォワーダと呼ぶ。
上位のキャッシュDNSサーバー ⇒ 根っこのルートサーバー等
- 通信の種類:反復問い合わせ(Iterative Query)
- 理由:パスを受け取った上位のサーバーが、インターネットの世界を実際に「ここ知りませんか?」と順番に聞き歩いて答えを探しに行く作業です。
b:プライオリティ値
こちらは知識問題なので、解説は割愛
設問2
(1)FW-L3SW間サブネット、内部サーバ収容サブネット
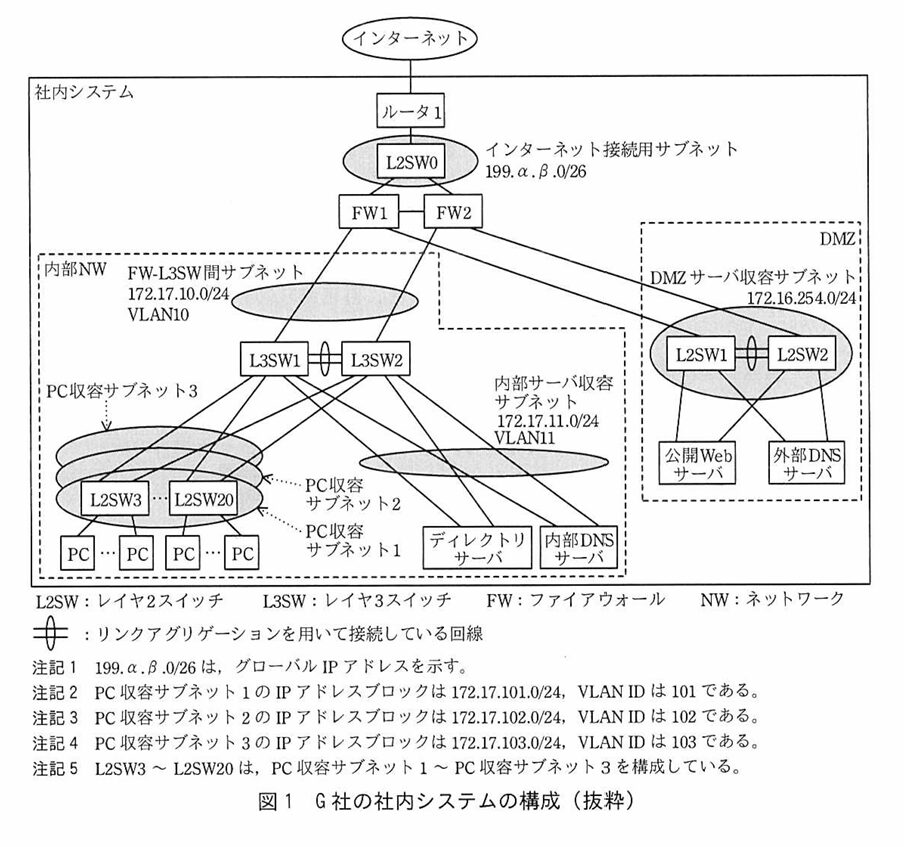
この問題の肝はL3SW1とL3SW2の間の直接リンクが使用できるか否かである。なので、たとえL3SW1がルートブリッジであったとしてもL3SW1とL3SW2の間にリンクが形成されていなければ、VRRPのやり取りはPC収容サブネット以外、不可!ということになる。
そして、今回の場合はルートブリッジがL2SW3になるということなので、それが意味するのは「L3SW1とL3SW2間のリンクはブロッキング、または指定ポートとなる」のでそこの間では転送処理ができなくなってしまうということ。つまり、リンクが遮断されているのと同じ状況になる。
捕捉前提:
VRRPパケットの制約
VRRPパケットは自分が属すポートからしか送出されない。そのため、👆上の図で当てはめると、L3SW1のFWと接続しているポートで稼働するVRRPの情報はそのポートからしか送出できないということ。そのパケットがPC収容サブネットと接続しているポートから送出されることはないので、L3SW2には届かないということ。
FWやサーバの制約
:FWやサーバはスイッチではないためマルチキャストパケットを他のポートにフラッディングしない。そこで終端する。そのためFW1がVRRPパケットを受け取っても、そのパケットがFW2に届くことはない。なので結果的にL3SW1のパケットはFW1→FW2を経由してL3SW2に届くことは起こりえない。
設問3
(2)短縮できる理由:①ポートの故障時の代替ポートを事前に決定しているから ②転送遅延がなく、ポートの状態遷移を行うから
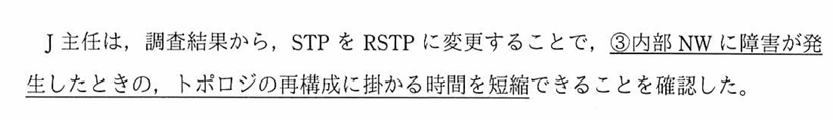
①ポートの故障時の代替ポートを事前に決定しているから
代替ポートがあることで、ルートに障害が起きても再度、BPDUなどをやり取りせずに即座に代替ポートをルートポートに変更しFowrding状態を維持できるようになる。
従来のSTPだと….まずTCNフレームを送信したり、Listening→Learnig→Fowrdingといった30秒の待ちが発生したりと色々と時間がかかっていた
②転送遅延がなく、ポートの状態遷移を行うから
RSTPではProposal・Agreementで状態遷移を実行している。そのため、旧来のタイマー待ちが発生しない。
別解として「タイマー待ちが発生しないから」という旨の回答でもよさそう!
旧来のSTPだと…Listening,Learnigでそれぞれ15秒ずつのタイマー待ちが必須だった。
設問4
(1)2台のL3SWを1台のスイッチとして管理できるから
スタック機能のメリットは、複数の物理スイッチを1台の論理スイッチのように管理・運用できること
設問6
(1)source MAC:現行のディレクトリサーバ destination MAC:新ディレクトリサーバ
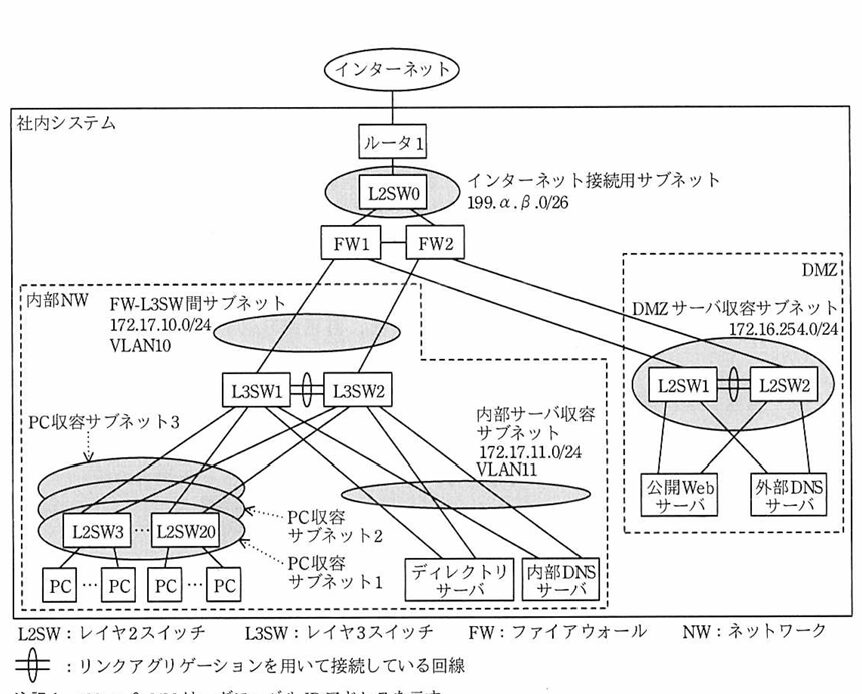
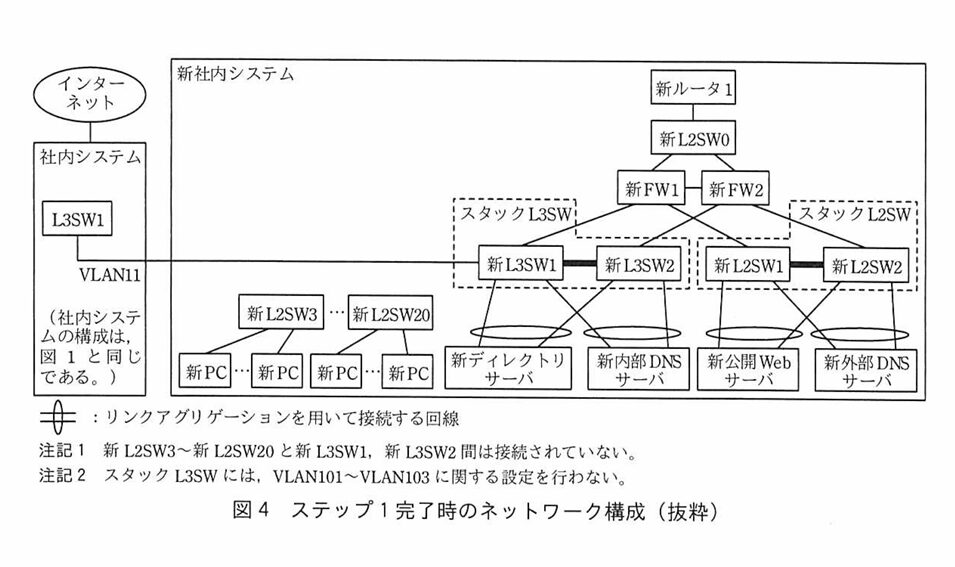

前提:
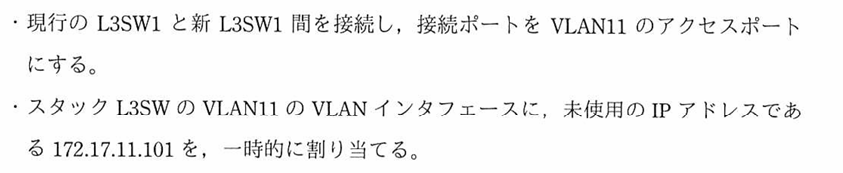
・現行のL3SW1と新L3SW1はVLAN11のアクセスポート
・スタック L3SW の VLAN11の VLAN インターフェイスに172.17.11.101を割り当てる
・172.17.11.101は旧ディレクトリサーバと同一サブネット
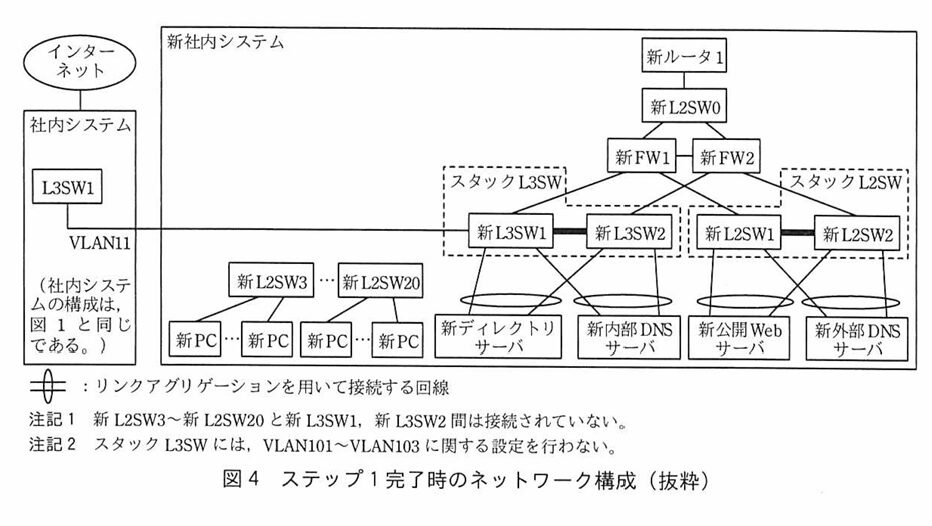
上記、前提より現行のL3SW1とスタックL3SWの間は、ルーティング(L3ルーティング)を行わずに、ただの「同一レイヤ2セグメント(同一VLAN11のブリッジ)」として繋がれている!
(2)source MAC:現行のL3SW1 destination MAC:スタックL3SW
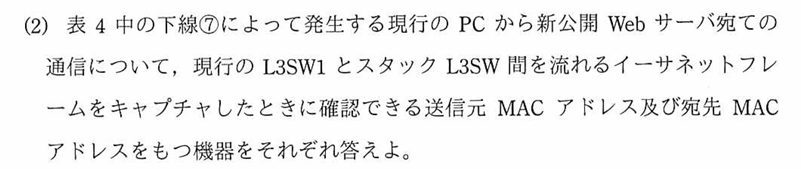
設問6(1)で説明した時は、同一サブネット内の場合はL2を書き換えないというもの。一方、今回は異なるサブネットへの通信なので、スタックL3SWはL3ルーティングを実施する。ということは、MACアドレスの書き換えが行われて、「source MAC:現行のL3SW1 destination MAC:スタックL3SW」という結果になる。
(3)172.16.254.128 ~ 172.16.254.254
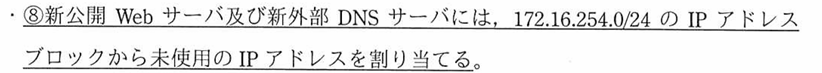


上の表より、172.16.254.0/24の中で、10~100は既に使われていることが分かる。また、新ネットワークでは、172.16.254.128/25がネットワークアドレスとして使われていることが分かる。
172.16.254.255はブロードキャストアドレスであるため割り当て対象から除外。
172.16.254.128はネットワークアドレスであるため割り当て対象から除外。
これより、172.16.254.129~172.16.254.254となる。。。はずだが、答えは、172.16.254.128~172.16.254.254となっている。。。。なぜ?わからない。。。誰かわかる人、コメントで教えてください。。。
(4)現行のFWと新FWの仮想IPアドレスが重複する
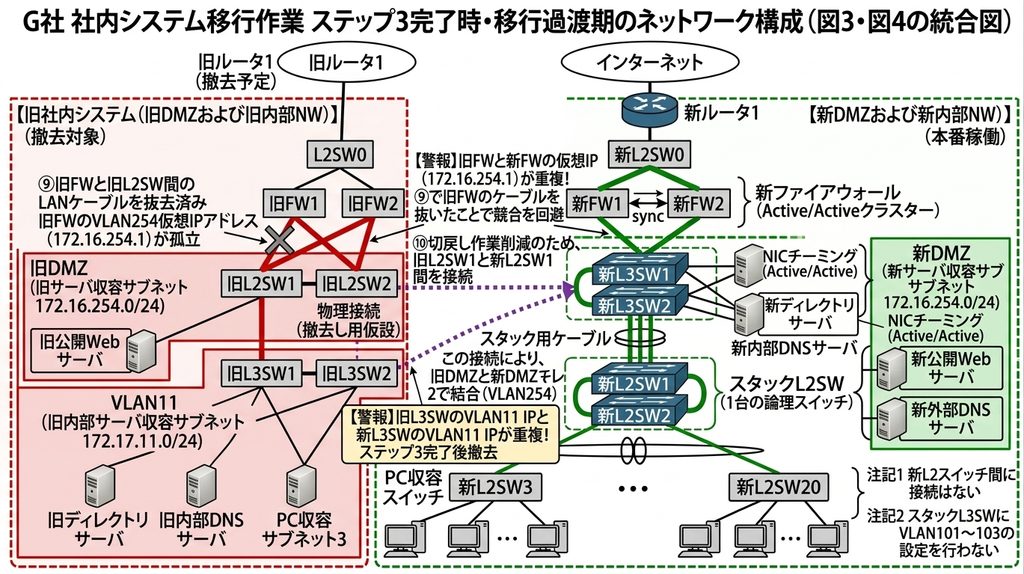


回答を見て一番最初に疑問に思うことは、「え?新旧は別セグメントなんだからIPアドレス重複しててもよくね?」ということ。しかし、本文を読み進めると以下のように記されている。
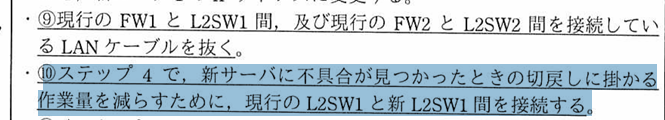
⑩を見ると、新旧のL2SW1を接続すると書かれている。つまり、DMZ内のサーバがFW宛てにARPを送ると、同一サブネットにある旧ネットワークにもその通信が届いてしまうということになる。そして、もし旧L2SW1と旧FWが依然としてリンクされているとIPアドレスが重複しているので、旧FWからARP応答が返ってきてしまう。そして、誤ったFWに通信をしてしまう可能性があるということ。
回答は、「現行のFWと新FWの仮想IPアドレスが重複する」という描写するよりも「古いファイアウォールに応答・転送されて通信できなくなる」と回答した方が設問の”どういう問題が起きる?”という回答にふさわしい気がする。
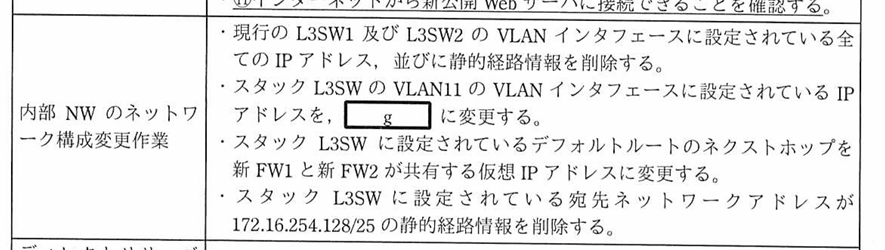
(7)172.17.11.1
Q.そもそもなんで最初から172.17.11.1を割り当てなかったの?
新ネットワーク移行中には、旧ディレクトリサーバと新ディレクトリサーバをやり取りするために、スタックL3SWにVLAN11インタフェース172.17.11.101を割り当てていた。「いや、最初から172.17.11.1を割り当てればよくね?」
A.「最初から .1 にすると、古い方のシステムとIPアドレスが重複しちゃうからダメだよね」ということ。なので、一時的に172.17.11.101を割り当てていた。
Q.なんで172.17.11.1なの?
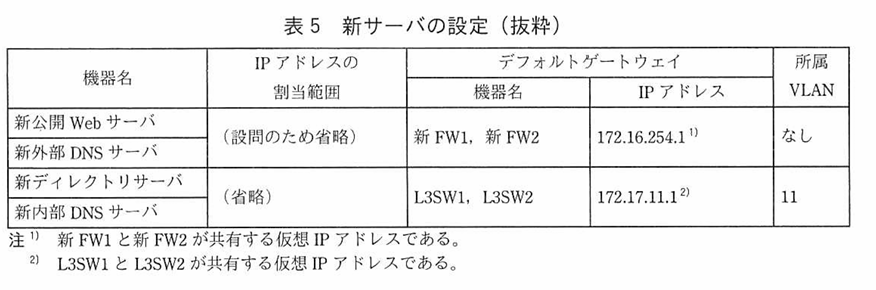
表5を見ると、新ディレクトリサーバと新内部DNSサーバのデフォルトゲートウェイは172.17.11.1に設定されている。そのため、サーバたちが「172.17.11.1」宛てにパケットを投げたとき、そのルータ側の玄関口(スタックL3SWのVLAN11インターフェース)が受け取れるように、スイッチ側にも同じ 172.17.11.1 を設定してあげる必要がある。
(8)PCが収容されているサブネットを識別し、対応するDHCPのスコープからIPアドレスを割り当てるため
#スタックL3SW
int vlan 101
 ip address 172.17.101.1 255.255.255.0
 ip helper-address DHCPサーバのIP

#giaddrフィールドに入るのはこのvlanインタフェースに割り当てられたIPアドレス
DHCPリレーエージェントを実行すると、ルータがPCの代わりにDHCP 要求を実行してくれる。しかし、それによってDHCPサーバは「いや、ルータから来たのはわかったけど、俺はどのDHCPプールから君にIPアドレスを払い出したらいいの?」となってしまう。
そこで!転送する側のルータがDHCP Discoverを受け取ったインタフェースのIPアドレスをgiaddrフィールドに格納することでプールが明確になる。
#DHCPサーバ
ip dhcp excluded-address 172.17.101.1
ip dhcp excluded-address 172.17.101.53

ip dhcp pool プール名
 network 172.17.101.0 mask 255.255.255.0
 default-router 172.17.101.1
 dns-server 172.17.101.53
 lease 日 時間
p.2 Q.現行のVLAN設定方法は?
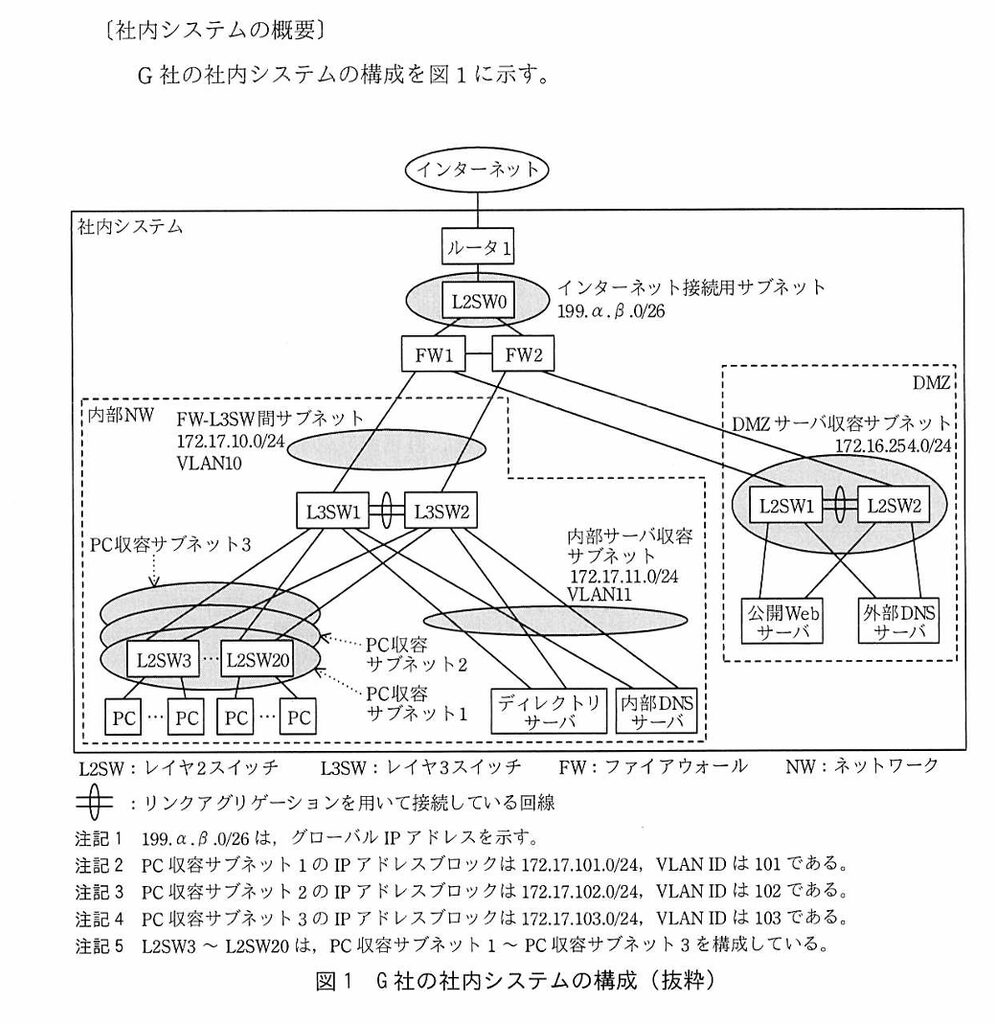
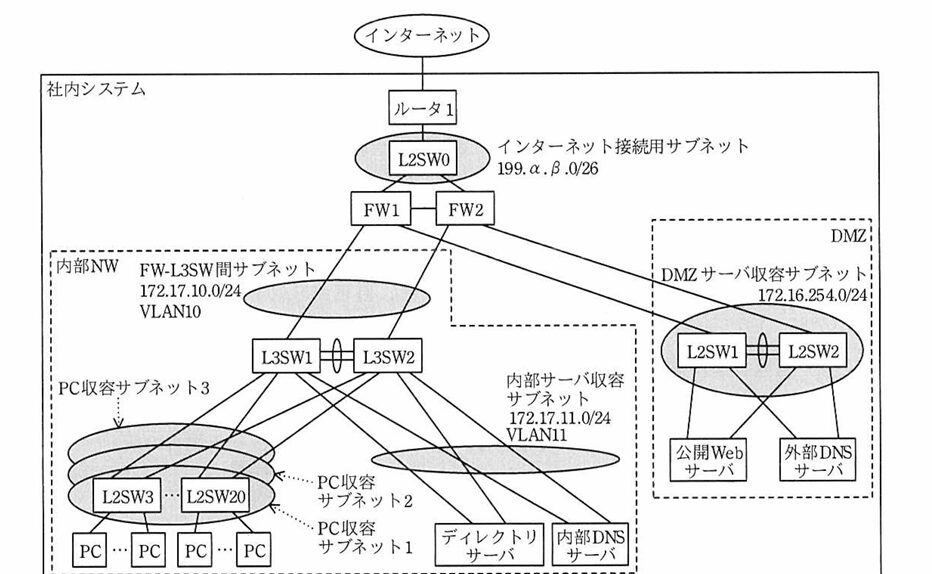
この構成図を確認すると、1つのL2SWが複数のサブネットと接続(=複数のVLANを持っている)ことが分かる。では、実際にどのようなコマンドが使われているのか見ていこう!
▼L2SW
enable
configure terminal

hostname L2SW3

vlan 101
 name vlan101
 exit

vlan 102
 name vlan102
 exit

vlan 103
 name vlan103
 exit

#PCとつながるポート
interface g0/0
 switchport mode access
 switchport access vlan 101

interface g0/1
 switchport mode access
 switchport access vlan 102

interface g0/2
 switchport mode access
 switchport access vlan 103

#L3SWとつながるポート
interface g1/1
 switchport trunk encapsulation dot1q
 switchport mode trunk
 switchport trunk allowed vlan 101,102,103
▼L3SW
enable
configure terminal

hostname L3SW1

#SWとつながるポート
interface g0/1
 no shut

interface g0/1.101
 encapsulation dot1q 101
 ip address 172.17.101.2 255.255.255.0
 vrrp 1 ip 172.17.101.1
 vrrp 1 priority 110


interface g0/1.102
 encapsulation dot1q 102
 ip address 172.17.102.2 255.255.255.0
 vrrp 1 ip 172.17.102.1
 vrrp 1 priority 110


interface g0/1.103
 encapsulation dot1q 103
 ip address 172.17.103.2 255.255.255.0
 vrrp 1 ip 172.17.101.1
 vrrp 1 priority 110
*補足:
・サブインタフェース番号は1~4,294,967,295(約42億)まで 設定することができる
・サブインタフェースにはVRRPの仮想IPアドレスのほかに物理IPも設定する必要がある。
・VRRPのデフォルトプライオリティは100なので、マスターを優先させたい機器がある場合は100よりも大きな値にする
Q.再帰問い合わせとフォワーダの違いは?
再帰問い合わせとフォワーダは似ていてややこしいので実際の流れを見ながら違いを理解していこう!
1.PC(クライアント) ⇒ 社内DNSサーバー
・通信の種類:再帰問い合わせ(Recursive Query)
・理由:「このドメインのIPアドレスを絶対に調べて教えて!」と、答えを丸投げして要求する通信。PCのスタブから社内DNSに対して行われる。
2.社内DNSサーバー ⇒ ISPのキャッシュDNSサーバへ
・通信の種類:フォワーディング(転送)
・理由:社内DNS自身が答えを持っておらず、自分で反復問い合わせをする代わりに、受領した再帰問い合わせの依頼をそのままISPのキャッシュDNSサーバへ「丸ごとパス(委託)」する動作。
*問題文中にもISPに転送と記されている👇
3.ISPのキャッシュDNSサーバ ⇒ ルートサーバー等
・通信の種類:反復問い合わせ(Iterative Query)
・理由:パスを受け取った上位のサーバーが、インターネットの世界を実際に「ここ知りませんか?」と順番に聞き歩いて答えを探しに行く作業です。
・このISPキャッシュサーバがDNSSECを検証してくれるので、末端のフォワーダやスタブはDNSSEC検証をしなくてもよい
p.3 Q.NICチーミングってなに?
NICチーミングとは、複数のNICを論理的に1つのNICとして扱う技術。
Q.MACアドレスはどうなるのか?(同じになるのか?)
結論:仮想MACアドレスが割り当てられ、アクティブ側もスタンバイ側も「同じMACアドレス」を使用する
解説:チーミング機能が有効になると、OS上では物理NICそれぞれの固有のMACアドレスとは別に、「チーミンググループ全体の共通MACアドレス(仮想MACアドレス)」が生成される。
通信するとき(フレームを送信するとき)は、常にこの共通の仮想MACアドレスが送信元MACアドレスとして使われる
Q.アクティブ側に障害が起きたら?
結論:GARP(Gratuitous ARP)を使って上位スイッチのMACアドレステーブルを更新する。
VRRPでGARPは出てくるので、GARPはVRRP専用の技術と勘違いしがちだが、NICチーミングでも使える技術。これによって、上位スイッチは「あ、このポートにこのMACアドレスあるんだね」と学習してMACアドレステーブルを更新できる。
p.3 Q.VRRPアドバタイズメントはどこを流れるの?
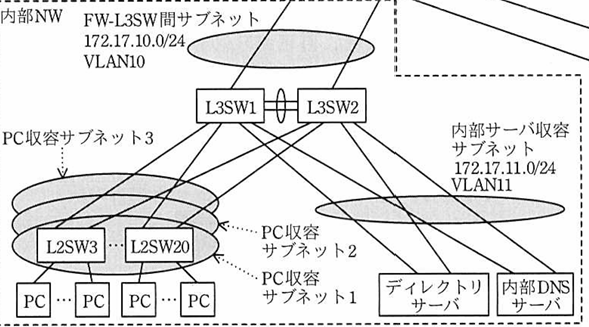
L3SW1とL3SW2ではVRRPが稼働している。VRRPでは生存確認としてVRRPアドバタイズがマルチキャスト224.0.0.18で送信される。構成図上のどこにそのパケットが流れているのかはっきりさせていこう!
結論:同一のVLAN(サブネット)に属しているポートのみに送られる。例えば、VLAN101に属しているポートでVRRPを動作させた場合は、VLAN11に属しているポートにはマルチキャストを送らなくなる。
p.3 Q.STPってなに?

STP(Spanning-Tree-Protocol)はL2におけるループを防ぐためのプロトコル。L2にはL3のようなTTLがないため、一度ループが発生するとそれは半永久的にループし続けるというブロードキャストストームが発生する。それを防ぐのがSTP。
大枠は理解できたので、次は詳細に踏み込んでいこう!
Q.BPDUはブロードキャストで送られるの?
A.BPDUはブロードキャストではなく、「L2マルチキャスト(レイヤ2のマルチキャスト)」として送信される
- IEEE 802.1D(STP)のBPDUは、宛先MACアドレスに
01:80:c2:00:00:00という特殊なマルチキャストアドレスを指定して送信される。 - (※ちなみに、すべてのビットが
1のFF:FF:FF:FF:FF:FFが「ブロードキャスト」) - もしこれを完全なブロードキャスト(
FF:FF:FF:FF:FF:FF)にしてしまうと、ネットワーク内につながっている一般のPCやサーバーのNICやOSまでもがそのパケットを受け取って処理(CPUに負荷がかかるなど)してしまう。 - しかし、STPのBPDUが必要なのは「スイッチ(ブリッジ)同士」だけ。そのため、「スパニングツリーを理解・参加する機器グループ」宛てであるL2マルチキャスト(
01:80:c2:00:00:00)を使うことで、無関係なPCやサーバーに無駄な処理をさせないようになっている。
Q.ルートブリッジの決定方法
ルートブリッジを決定するにはBPDUを交換して、ブリッジIDが最も小さいものが選出される。しかし、詳しいフローはまだよくわからないので、ここでしっかり理解しよう!
1.スイッチは起動後、BPDUをL2マルチキャスト(01:80:c2:00:00:00)する
| BPDUの主な情報 | 起動直後のSW2の例 |
|---|---|
| Root Bridge ID | 自身のBridge ID |
| Root Path Cost | 0 |
| Sender Bridge ID | 自身のBridge ID |
| Sender Port ID | 送信ポートの識別情報 |
| Timer情報 | Hello Time、Max Age、Forward Delayなど |
2.BPDUを比較して、ルートブリッジを決める
・BPDUを交換すると、より優れた(Superior)BPDUを受け取ったスイッチは、自分の認識しているルートブリッジを更新する。
・ルートブリッジの選出基準は、Bridge IDが最も小さいこと。
Q.ルートポートの選出方法は?
ルートブリッジが決まった後に考えるのは、複数のポートのうち、どのポートを使えばルートブリッジまで最もよい経路で到達できるかである。
1.他のスイッチからのBPDUを確認してルートパスコストを計算する
BPDUにはルートパスコストがあるため、その情報をもとに最小となるポートをルートポートとする
▼比較順
①より小さいRoot Bridge ID(ルートブリッジID)
②より小さいRoot Path Cost(ルートまでのコスト)
③より小さい送信元のBridge ID
④より小さい送信元のPort ID
⑤それでも同じなら、受信側のPort ID
捕捉:パスコストは帯域幅が大きいリンクほどパスコストが小さくなり、帯域幅が小さいリンクほどパスコストが大きくなる仕組み
#パスコスト算出法をlongにする
Switch(config)# spanning-tree pathcost method long
▼よく使われる代表値
| 帯域幅 | ショート | ロング |
|---|---|---|
| 100 Mbps | 19 | 200,000 |
| 1 Gbps | 4 | 20,000 |
| 10 Gbps | 2 | 2,000 |
| 40 Gbps | 1 | 500 |
| 100 Gbps | 1 | 200 |
| 1 Tbps | — | 20 |
Q.指定ポートの選出方法は?
1.BPDUを交換し、セグメント間(同一リンク)で比較する
①ルートパスコストが小さい方
(同一階層だと、ルートパスコスコスとが同じになることがある)
②Bridge IDが小さい方
③送信元ポートIDが小さい方
捕捉:指定ポートは1つのスイッチが複数持つことが可能。リンクがあればその分、指定ポートも存在することになる。
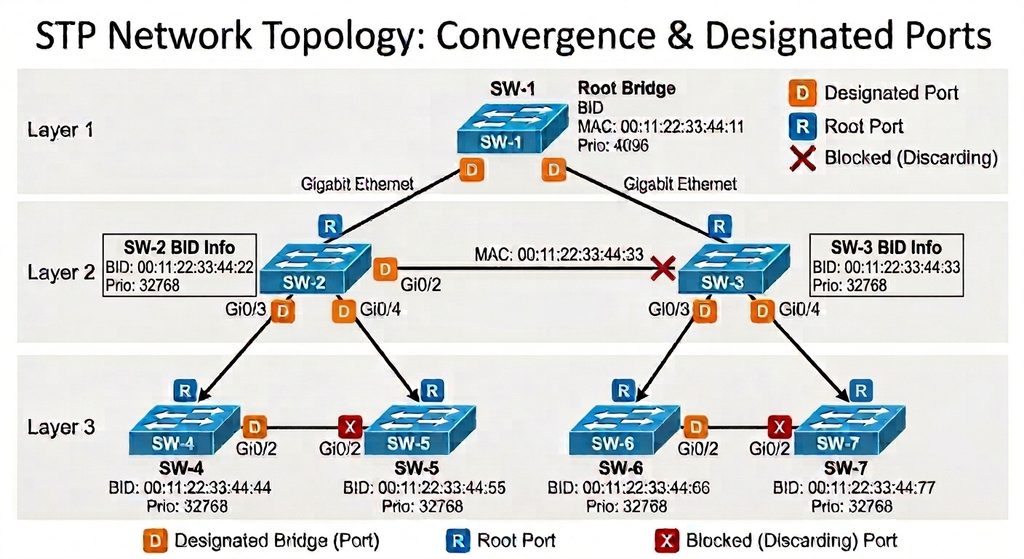
Q.STPの状態遷移はどうなっているの?
では、STPのDisabled → Blocking → Listening(15秒) → Learning(15秒) → Forwardingの流れを見ていこう!
1. Disabled(停止状態)
- どんな状態?:ポートの電源が落ちている、または物理的にケーブルが抜けている(リンクダウン)など、STP的に完全に無効な状態。
- できること:データの送受信も、BPDUのやり取りも一切なし。
2. Blocking(待機・ブロック状態)
- どんな状態?:ループを防ぐために、データ通信を「塞がれている」状態(選出の結果、ブロックポート/非指定ポートになったポートがここに留まる)。
- できること:
- データフレームの送受信:× 不可(ループを防ぐため)
- BPDUの送受信:△ 受信のみ可能(※「送信」はしないが、隣から来るBPDUを受け取って、ルートの変化や障害を監視し続ける)
- 備考:電源を入れた直後のポートも、まずはここからスタートする。
3. Listening(聴取状態)
- どんな状態?:「よし、今からこのポートの役割(RPやDP)を正式に確定させるぞ!」という準備期間。
- できること:
- データフレームの送受信:× 不可
- BPDUの送受信:◯ 送受信可能(自分もBPDUを出して、お互いの役割を最終確認)
- ここがポイント(タイマー):
- このリスニング状態には、デフォルトで 15秒間(Forward Delayタイマー) 留まる。
4. Learning(学習状態)
- どんな状態?:役割が決まり、もうすぐ通信が始まるところ。焦ってデータを流すとループの危険があるため、まだデータは通さないが、「準備運動」を始める。
- できること:
- データフレームの転送:× まだ不可(流れてきても捨てる)
- MACアドレスの学習:◯ 可能!(ポートに流れてくるフレームの送信元MACアドレスを見て、「あ、この端末はこのポートの先につながっているんだな」とMACアドレステーブルに登録し始める)
- なぜこの状態が必要なのか?(試験の頻出ポイント!):
- もしラーニング期間なしでいきなりフォワーディング(データ転送)を始めると、スイッチはMACアドレステーブルが空っぽの状態なので、最初は必ずフラッディング(全ポートへのばらまき)を起こす。これが原因で瞬間的なブロードキャストストーム(負荷急増)が起きるのを防ぐため、あらかじめMACアドレスを覚えておく時間を挟んでいる。
- ここがポイント(タイマー):
- このラーニング状態にも、デフォルトで 15秒間(Forward Delay) 留まります。
- MACアドレスの学習はBPDUではなく実際のデータフレームを使って学習される。つまり、ユーザが送信したデータはこの学習期間中は破棄される。
5. Forwarding(転送状態)
- どんな状態?:すべての安全確認と準備が整い、「通常営業」が始まった状態。
- できること:
- データフレームの送受信・転送:◯ 完全可能!
- BPDUのやり取り:◯ 継続して行う
Q.障害が発生したらどういうフローで再構築するの?
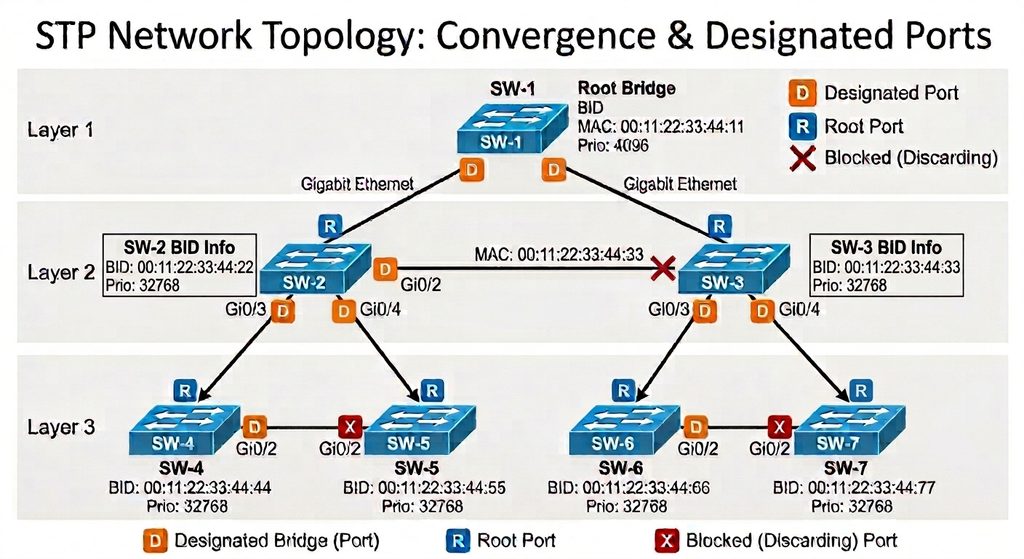
ステップ1:障害の検知(「あれ、BPDUが来ないぞ?」)
- 何が起きる?:
- 通常、下流のスイッチ(ルートポートがある側)は、上流の指定ポートから2秒おきにBPDUを受信し続ける。
- もしメインの回線が切れると、上流からのBPDUがピタッと止まる。
- Max Age(マックスエージ)タイマーのカウントダウン:
- 「おや、いつも来るはずのBPDUが来ないぞ……?」とスイッチが不審に思い始める。
- クラシックなSTPでは、最後にBPDUを受け取ってから 最大20秒間(Max Ageタイマー) は、すぐに諦めずに「ちょっと様子見(待機)」をする。この20秒の間に一時的な通信の揺らぎで復活すればセーフだが、20秒経ってもBPDUが来なければ「あ、これマジで障害だ!」と確定させる。
ステップ2:ルートポートの喪失と「予備(ブロックポート)」の覚醒
- 何が起きる?:
- メインのルートポート(RP)がつながっていたリンクが死んだと分かると、そのスイッチは「あぁ、ルートブリッジへの道が閉ざされてしまった!」と判断する。
- このとき、もしネットワーク内に「普段は塞がれていた予備のポート(ブロックポート / BP)」が存在していれば、そのポートに光が当たる。
- どう切り替わる?:
- 塞がれていたブロックポートは、ルートブリッジへの新しい「第2候補のパス(あるいは別の回り道)」として機能できるため、即座にリスニング(Listening)状態へと昇格する。
ステップ3:トポロジー変更の通知(TCN BPDUの拡散)
- 何が起きる?:
- 経路が変わった(トポロジーに変化があった)ことをネットワーク全体のスイッチにいち早く教えるため、障害に気づいたスイッチは、TCN(Topology Change Notification)BPDUという専用の「お知らせ用パケット」を、今度は逆にルートブリッジ側(生きているルートポート経由など)に向けて上へ上へと送信する。
- ルートブリッジの反応:
- 上から伝わってきたTCNを受け取ったルートブリッジは、「みんな!ネットワークの形が変わったから、MACアドレスの保持時間を短縮してくれよな!」という全体通知(TCフラグ付きのBPDU)を全スイッチにばらまく。
ステップ4:ステートの移行と復旧(Listening ➔ Learning ➔ Forwarding)
- 何が起きる?:
- ステップ2で新しくルート候補に選ばれたポートは、いきなり通信を始めるとループの危険があるため、例のあのステップを踏む。
- リスニング状態(15秒):役割の再確認
- ラーニング状態(15秒):新しい経路用のMACアドレスの学習
- 完全復旧:
- ラーニングが終わると、いよいよそのポートがフォワーディング(Forwarding)状態になり、新しい迂回路(バックアップ経路)を通じたデータ通信が正式にスタートする。
捕捉:問題点としては、ルートブリッジのTCフレームが関係のないスイッチにも届くということ。例えば、上図のSW2のGi0/4に障害が起きた場合、SW3側配下のSW6,7には左側のトポロジーの変化はどうでもよい。しかし、STPではTCフレームは全体に波及してしまうという問題点があった。
Q.RSTPって何?
RSTP(Rapid Spanning Tree Protocol / IEEE 802.1W)はSTPよりも高速にコンバージェンスするL2プロトコルである。では、深く見ていこう!
Q.RSTPのポートの種類は?
① Root Port(ルートポート)
Root Bridgeへの最良経路
② Designated Port(指定ポート)
各LANセグメントで、最も優れたBPDU情報を提示する側のポート
③ Alternate Port(代替ポート)
・Root Portの予備経路
・Root Portには選ばれなかったものの、別のスイッチ経由でRoot Bridgeへの代替経路を持つポートです。
・通常はDiscarding状態
④ Backup Port(バックアップポート)
・Designated Portの予備
・同じLANセグメント上で、自分のスイッチのDesignated Portをバックアップするポート。
・同一セグメント内でのバックアップ
・通常はDiscarding状態
・特殊な共有メディア構成などで登場し、一般的なスイッチ間接続ではまれ
Q.プロポーザルとアグリーメントって何?
- プロポーザル(Proposal = 提案)
- 上流(親)のスイッチが下流(子)のスイッチに向けて、「俺がこのリンクの親(指定ポート)になるから、お前はルートポートになって、今すぐデータを流し始めてくれよ!いいか?」と提案するアクション。
- BPDUのフラグの一つ
- アグリーメント(Agreement = 同意)
- それを受けた下流(子)のスイッチが、「OK!こっちの安全(ループ対策)は全部整ったから、データを流すことに同意するよ!」と上流へ返事をするアクション。
- BPDUのフラグの一つ
Q.RSTPのポート選出フロー
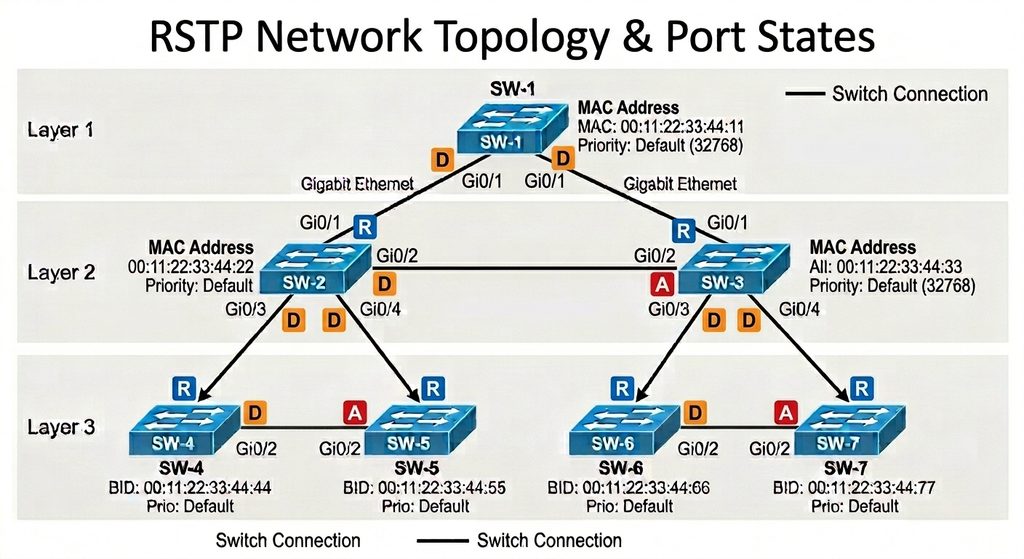
1.各スイッチがBPDUをL2マルチキャスト(01:80:c2:00:00:00)で送信
2.ルートブリッジの選出
・BPDUから最小のブリッジIDを持つスイッチをルートブリッジとして選出する
3.ポートの役割選出
・ルートパスコストやブリッジIDをもとにルートポート、指定ポート、代替ポートを決める。
*多くの場合、バックアップポートが選出されることはない。
4.プロポーザル・アグリーメントのやり取り
①上位スイッチの指定ポートは下位に「俺は指定ポートだから、君のポートをルートポートにしてFowrwarding状態にしちゃいなよ」と送る。(=proposal)
②下位スイッチは自身のスイッチ内で、ほかのポートを一時的にすべてDiscarding状態にして安全にロックする。(=Syn)
③②の準備ができたら、上位スイッチに「OK、準備できたから転送可能状態だよ!」と伝える。(=agreement)
Q.RSTPで障害が起きたら?
では、ここでは2つのシナリオとともにフローを確認していこう!
▼シナリオ1:SW2のGi0/1ポートに障害が起きた場合
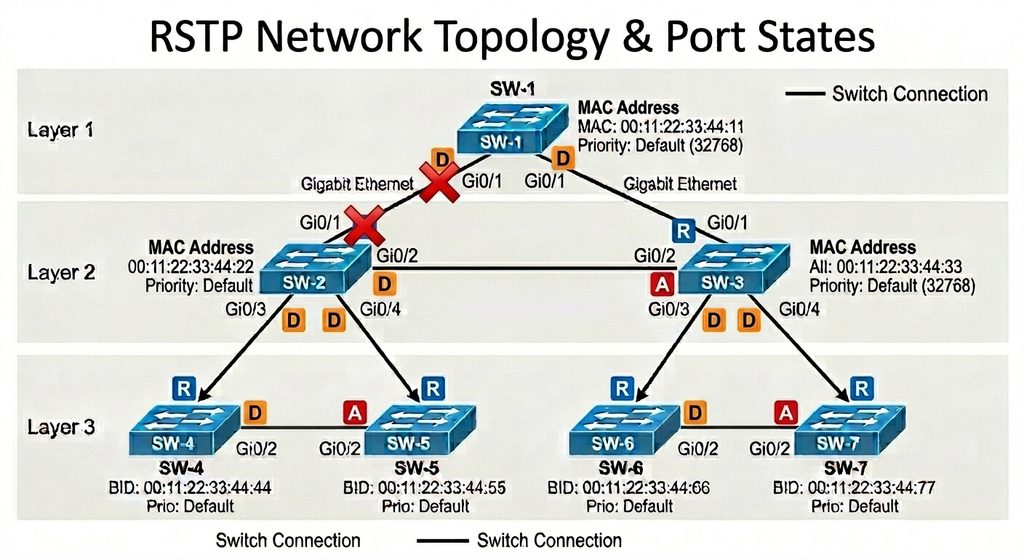
1.SW-2内で障害を検知
従来のSTPでは、障害検知に対向側がMax-Age(20秒)待つ必要があった。しかしRSTPではスイッチ内で障害を検知することができる。
2.BPDUを更新してSW-3を指定ポートにする
BPDUを更新することで、ルートパスコストが障害前よりも大きな値になる。それをSW-3が検知すれば、「あ、俺を指定ポートにすべきだ!」と判断できる。
3.ProposalとAgreement
・SW-2とSW-3でProposalとAgreementをやり取りして瞬時にフォワード状態にする
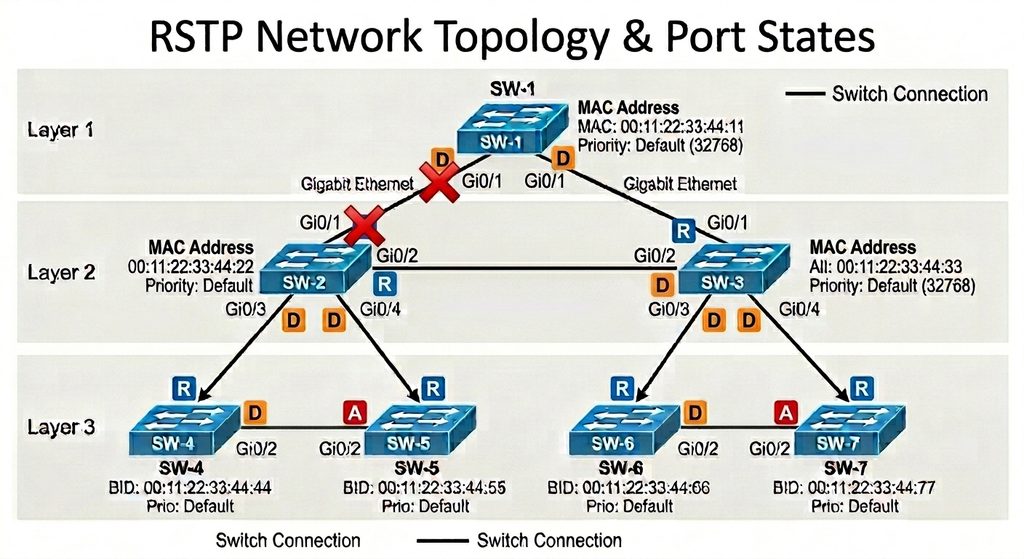
👆収束後のトポロジー
▼シナリオ2:SW3のGi0/1ポートに障害が起きた場合
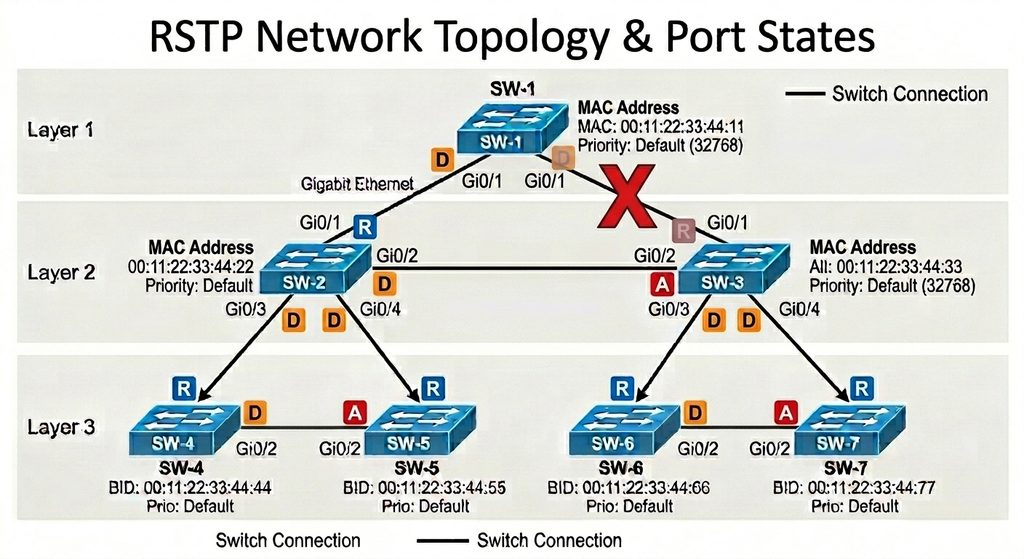
1.SW-3内で障害を検知
従来のSTPでは、障害検知に対向側がMax-Age(20秒)待つ必要があった。しかしRSTPではスイッチ内で障害を検知することができる。
2.SW-3のAlternativeをルートポートにする
SW-3では、ルートポートのダウン時の代替ポートを事前に作成ずみなのでスムーズにルートポートに移行する
*この際、BPDUは不要!なぜなら既に作成済みだから
3.転送可能状態
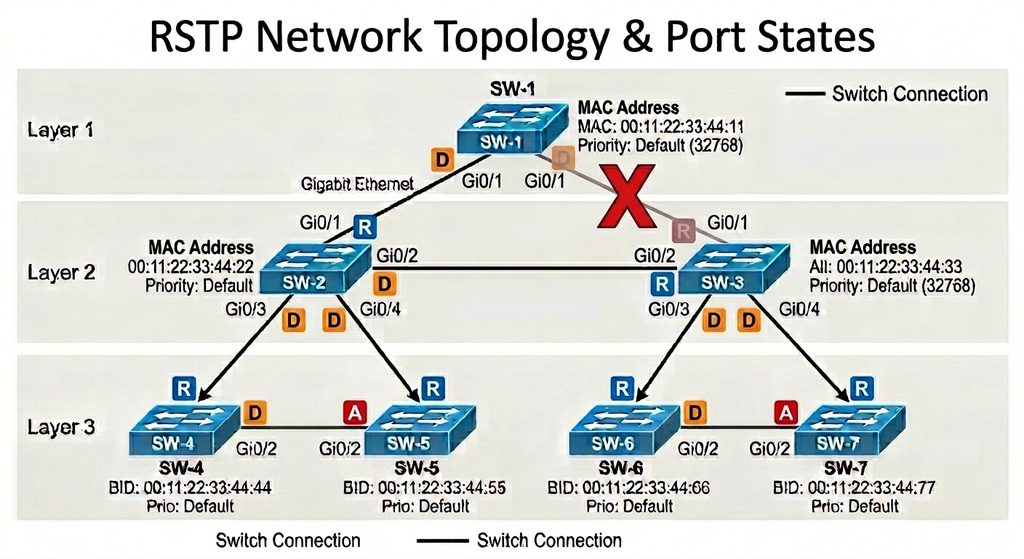
👆収束後のトポロジー
p.7 アクティブ/アクティブのチーミングって何?
そもそもNICチーミングって何?
A.1台のサーバーに物理的なネットワークカード(NIC)が複数枚刺さっているとき、それらをOS上で束ねて「1つの論理的なNIC」として扱えるようにする技術。これにより、万が一1枚のNICやケーブルが故障しても、もう片方が通信を肩代わりして止まらないようにする(高可用性・冗長化)ことができる。
アクティブ/アクティブとは?
A.束ねた複数の物理NIC(例えばNIC AとNIC B)のすべてを同時に「現役(アクティブ)」として稼働させる方式。片方が予備として眠っている(アクティブ/スタンバイ)のとは異なり、2枚(あるいはそれ以上)のNICを同時にフル活用する。
Q.スイッチ側はどうなっているの?
en
conf t

int range g0/0-1
 channel-group 1 mode active

int Port-channel1
 switchport mode access
 switchport access vlan 11
Q.スタックのIPアドレス振り分けはどうなっているの?
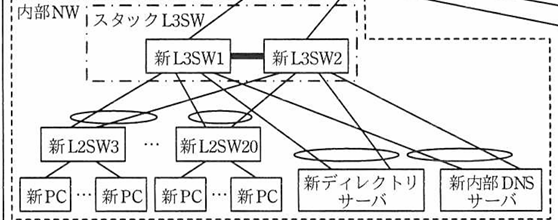
構成図では、新L2SW3と新L2SW20しか記載されていないからわかりにくいけど、実施はもっと多くのL2SWがスタックに接続している。
▼疑問点:
・新L3SW1・2の物理ポートにはIPアドレスを設定しているの?
・スタックL3SWはL3ルーティングとして機能するけど、IPアドレス構成はどうなっているの?1つの物理ポートにIPを設定したら、ほかのL2SWからの通信はそのサブネット使えなくなっちゃうじゃん?
結論:VLANインタフェースを使う!
VLANインタフェースを作成することで物理ポートに依存しないIP割り当てが可能になる。
#1.VLAN作成
Switch(config)# vlan 101
Switch(config-vlan)# name VLAN101-PC
Switch(config-vlan)# exit

#2.VLANにIPアドレス割り当て
Switch(config)# interface vlan 101
Switch(config-if)# ip address 172.17.101.1 255.255.255.0
Switch(config-if)# no shutdown
Switch(config-if)# exit

#3.物理ポートとVLANの紐づけ
Switch(config)# interface range GigabitEthernet 0/0-3,1/0-3,2/1-3
Switch(config-if)# switchport mode trunk
Switch(config-if)# switchport trunk allowed vlan 101,102,103
Switch(config-if)# end上記、設定によってどこの物理ポートから通信を受け取っても適したIPアドレスで受け付けることができる。要は1つの物理ポートで複数のサブネットに対応したデフォルトゲートウェイを構築することができるということ。